AI 보안 이야기를 하다 보면 같은 말을 서로 다르게 쓰는 경우가 많습니다. 머신러닝 연구자에게 "poisoning"은 학습 데이터를 오염시키는 공격이고, 보안 담당자에게 "injection"은 SQL 인젝션처럼 입력으로 명령을 끼워 넣는 공격입니다. LLM이 등장하면서 "jailbreak", "prompt injection", "indirect prompt injection" 같은 말이 더해졌는데, 이 말들이 정확히 어디까지를 가리키는지는 사람마다 조금씩 다릅니다.
용어가 어긋나면 위협 모델링부터 흔들립니다. 어떤 공격을 막았다고 할 때 그것이 무엇을 막았다는 뜻인지, 탐지 규칙이 어떤 범주를 다루는지 팀 안에서도 맞추기 어렵습니다.
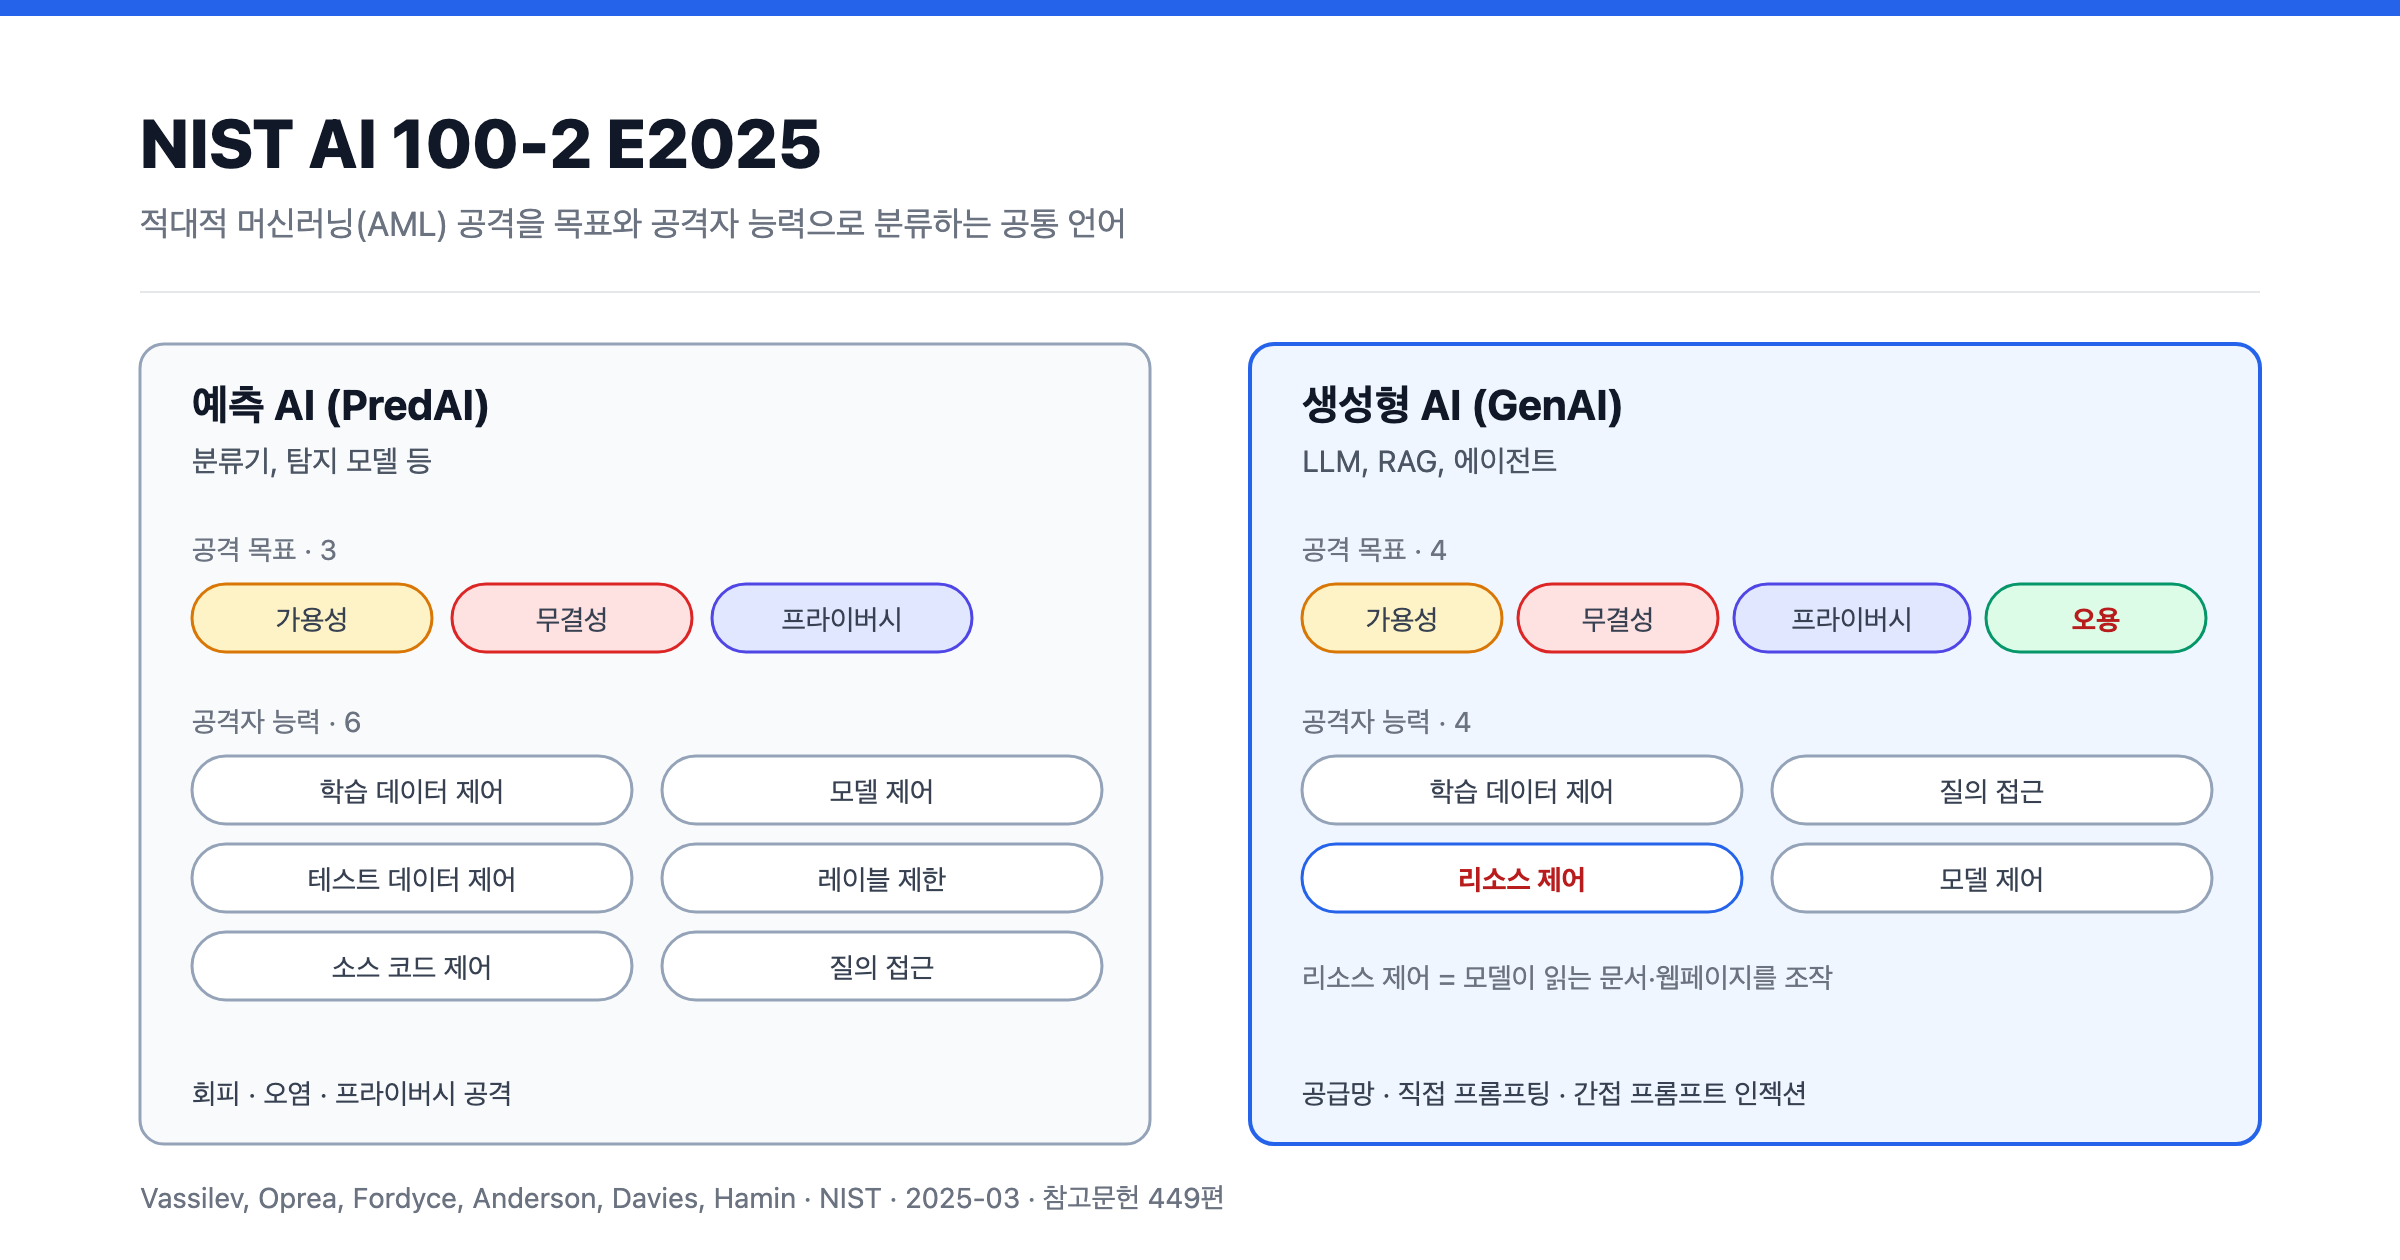
미국 NIST가 2025년 3월에 낸 NIST AI 100-2 E2025는 이 문제를 풀기 위한 보고서입니다. 적대적 머신러닝(Adversarial Machine Learning, AML) 공격을 공격 목표와 공격자 능력을 기준으로 분류하고, 각 공격에 NISTAML.022 같은 식별자를 붙였습니다. 예측 AI(분류기, 탐지 모델)뿐 아니라 LLM, RAG, 에이전트 같은 생성형 AI까지 다룹니다.
이번 글에서는 이 보고서가 공격을 어떤 기준으로 나누는지, 예측 AI와 생성형 AI의 분류가 어떻게 다른지, 방어는 어디까지 와 있다고 보는지 정리합니다. 마지막으로 이 분류 체계를 실무에서 어떻게 쓸 수 있을지도 살펴보겠습니다.
목차
- 보고서 정보
- 왜 분류 체계가 필요할까?
- 공격을 나누는 다섯 가지 기준
- 예측 AI: 목표 셋, 능력 여섯
- 회피 공격은 왜 막기 어려울까?
- 생성형 AI: 목표에 "오용"이 추가된 이유
- LLM이 인젝션에 약한 구조적인 이유
- 직접 프롬프팅과 간접 프롬프트 인젝션은 무엇이 다를까?
- 방어는 어디까지 와 있을까?
- 보고서가 꼽은 세 가지 과제
- 실무 관점에서 읽기
- 보고서의 범위와 한계
- 결론
- 참고 자료
보고서 정보
| 항목 | 내용 |
|---|---|
| 제목 | Adversarial Machine Learning: A Taxonomy and Terminology of Attacks and Mitigations |
| 식별자 | NIST AI 100-2 E2025 (NIST Trustworthy and Responsible AI 시리즈) |
| 저자 | Apostol Vassilev (NIST) · Alina Oprea (Northeastern Univ.) · Alie Fordyce, Hyrum Anderson (Cisco) · Xander Davies (U.K. AI Security Institute) · Maia Hamin (U.S. AI Safety Institute) |
| 발행 | 2025-03-24 |
| 분량 | 127쪽, 참고문헌 449편 |
| DOI | 10.6028/NIST.AI.100-2e2025 |
| 개정 계획 | NIST는 이 보고서를 매년 개정할 계획이라고 밝혔습니다 |
이 보고서는 법적 구속력이 있는 지침이 아니라, 다른 표준과 실무 가이드가 참고할 수 있는 용어와 분류를 제공하는 것을 목표로 합니다. 어느 수준의 위험까지 받아들일지(위험 허용 수준)는 조직과 사용 사례마다 다르다며 따로 권고하지 않습니다.
왜 분류 체계가 필요할까?
보고서는 두 가지 배경을 듭니다.
첫째, 연구가 너무 빠르게 늘고 있습니다. 보고서에 따르면 2021년 이후 arXiv에 올라온 적대적 머신러닝 논문만 2024년 7월 기준으로 11,354편이 넘습니다. 이 분야를 따라가는 사람끼리도 같은 공격을 다른 이름으로 부르는 일이 생깁니다.
둘째, 머신러닝에는 증명된 방어가 거의 없습니다. 현대 암호는 특정 조건에서 안전하다는 것을 수학적으로 증명할 수 있지만, 지금 널리 쓰이는 머신러닝 알고리즘에는 그런 증명이 없습니다. 오히려 널리 쓰이는 방어 기법의 효과에 한계가 있다는 불가능성 결과가 나오고 있습니다. 그래서 대부분의 방어는 "실제로 해 보니 효과가 있었다"는 경험적인 근거로 쓰이고, 새로운 공격이 나오면 뚫릴 수 있습니다.
방어가 계속 바뀔 수밖에 없는 분야일수록, 무엇을 막으려 하는지부터 같은 말로 정리해 둘 필요가 있습니다. 그래서 보고서는 분류 체계와 함께 용어집도 제공합니다.
공격을 나누는 다섯 가지 기준
보고서는 모든 공격을 다음 다섯 가지 기준으로 분류합니다.
| 기준 | 내용 |
|---|---|
| AI 시스템 종류 | 예측 AI(PredAI)인지 생성형 AI(GenAI)인지 |
| 수명주기 단계 | 학습 단계에서 일어나는지, 배포 후 추론 단계에서 일어나는지 |
| 공격 목표 | 무엇을 깨뜨리려 하는지 (가용성, 무결성, 프라이버시, 오용) |
| 공격자 능력 | 무엇을 제어할 수 있는지 (학습 데이터, 모델, 질의 등) |
| 공격자 지식 | 모델에 대해 얼마나 아는지 (화이트박스, 그레이박스, 블랙박스) |
이 중 핵심은 공격 목표와 공격자 능력의 조합입니다. 보고서의 분류 그림은 공격 목표를 원의 중심에 두고, 그 목표를 이루는 데 필요한 능력을 바깥 고리에, 해당 공격 종류를 능력에 연결된 말풍선으로 그립니다. "어떤 능력을 가진 공격자가 어떤 목표를 노리면 어떤 공격이 가능한가"를 한 번에 읽을 수 있는 구조입니다.
공격자 지식은 세 단계로 나눕니다.
- 화이트박스: 학습 데이터, 모델 구조, 하이퍼파라미터까지 모두 압니다. 비현실적으로 강한 가정이지만, 최악의 공격자를 가정해 방어를 평가하려고 씁니다. 방어 기법 자체를 알고 공격하는 적응형(adaptive) 공격도 여기에 포함됩니다.
- 블랙박스: 질의를 보내고 응답만 받을 수 있습니다. 가장 현실적인 가정입니다.
- 그레이박스: 그 사이입니다. 모델 구조는 알지만 가중치는 모르는 경우 등이 있습니다.
예측 AI: 목표 셋, 능력 여섯
예측 AI에 대한 공격 목표는 전통적인 보안의 세 가지 속성과 같습니다.
| 목표 | 식별자 | 뜻 | 대표 공격 |
|---|---|---|---|
| 가용성 파괴 | NISTAML.01 | 정상 사용자가 제때 믿을 만한 결과를 받지 못하게 함 | 데이터 오염, 모델 오염, 에너지·지연(energy-latency) 공격 |
| 무결성 침해 | NISTAML.02 | 모델이 공격자가 원하는 대로 틀린 예측을 하게 함 | 회피(evasion), 표적 오염, 백도어 오염, 모델 오염 |
| 프라이버시 침해 | NISTAML.03 | 학습 데이터나 모델 정보를 빼냄 | 멤버십 추론, 데이터 재구성, 속성 추론, 모델 추출 |
프라이버시라는 이름에 대해서도 설명을 붙였습니다. 전통적인 보안에서는 "기밀성"이라고 부르지만, 적대적 머신러닝 분야에서는 모델 가중치 같은 기밀 정보를 빼내는 공격과 학습 데이터를 노출시키는 공격을 합쳐 "프라이버시"라고 불러 왔기 때문에 그 관례를 따랐다고 합니다.
공격자 능력은 여섯 가지로 나눕니다.
| 능력 | 내용 | 쓰이는 공격 |
|---|---|---|
| 학습 데이터 제어 | 학습 데이터 일부를 넣거나 바꿈 | 데이터 오염 |
| 모델 제어 | 모델 파라미터를 조작함 (트로이 목마 삽입, 연합학습의 악성 업데이트) | 모델 오염 |
| 테스트 데이터 제어 | 배포된 모델에 들어가는 입력을 조작함 | 회피, 백도어 |
| 레이블 제한 | 학습 데이터의 정답 레이블은 바꿀 수 없음 | 클린 레이블 오염 |
| 소스 코드 제어 | 학습 알고리즘 코드나 서드파티 라이브러리를 바꿈 | 백도어 |
| 질의 접근 | 모델에 질의하고 예측을 받음 | 블랙박스 회피, 에너지·지연, 프라이버시 공격 |
"레이블 제한"은 공격자가 할 수 있는 일이 아니라 할 수 없는 일을 나타냅니다. 정답 레이블은 건드리지 못하고 데이터만 슬쩍 바꾸는 클린 레이블(clean-label) 오염이 더 어렵고 더 은밀하다는 점을 구분하려고 둔 항목입니다.
백도어 공격은 이 표에서 특이한 위치에 있습니다. 학습 데이터에 백도어 패턴을 심고, 배포 후에도 같은 패턴을 입력에 넣어야 작동하기 때문에 학습 데이터와 테스트 데이터를 모두 제어해야 하는 유일한 공격입니다.
보안 담당자에게 익숙한 사례도 있습니다. 보고서에 따르면 최초의 오염 공격은 2006년 웜 시그니처 생성, 2008년 스팸 메일 분류에서 발견되었습니다. 이후 악성코드 분류, 악성 PDF 탐지, 안드로이드 악성 앱 분류, 네트워크 침입 탐지에서도 오염과 회피 공격이 보고되었습니다. 머신러닝 기반 보안 제품 자체가 이 분류 체계의 대상이라는 뜻입니다.
회피 공격은 왜 막기 어려울까?
회피 공격은 입력을 사람이 알아채기 어려울 만큼만 바꿔서 모델이 틀리게 판단하도록 만드는 공격입니다. 이렇게 만든 입력을 적대적 예제(adversarial example)라고 부릅니다. 정지 표지판을 속도 제한 표지판으로 잘못 인식하게 만든 사례가 유명합니다.
보고서는 지난 몇 년 동안 제안된 방어 상당수가 더 강한 공격에 뚫렸다고 정리하며, 대표적인 연구를 다음과 같이 인용합니다.
- 탐지 기법 10가지 우회 (Nicholas Carlini, David Wagner, AISec 2017): UC 버클리의 두 연구자가 당시 제안된 적대적 예제 탐지 기법 10가지를 모두 우회하고, 방어를 평가할 때 지켜야 할 지침을 함께 제시했습니다. 두 사람은 같은 해 IEEE S&P에서 강력한 최적화 기반 공격(흔히 C&W 공격이라고 부릅니다)도 발표했습니다.
- 경사 가리기 방어 우회 (Anish Athalye, Nicholas Carlini, David Wagner, ICML 2018): 모델의 경사(gradient)를 감춰서 최적화 공격을 막으려던 방어 여러 개를, 경사를 근사하는 기법으로 우회했습니다.
- 적응형 공격으로 방어 13가지 무력화 (Florian Tramèr 외, NeurIPS 2020): 방어 방식을 알고 그에 맞춰 설계한 적응형 공격으로 기존 방어 13가지를 뚫었습니다. 새 방어는 잘 알려진 공격이 아니라 적응형 공격으로 시험해야 한다고 주장했습니다.
- 탐지는 분류만큼 어렵다 (Florian Tramèr, ICML 2022): 적대적 예제를 탐지하는 문제가 강건한 분류기를 만드는 문제만큼 어렵다는 것을 보였습니다. 공격을 막는 대신 탐지하는 길로 돌아가도 쉽지 않다는 뜻입니다.
그 가운데 비교적 버텨 온 방어로 세 가지를 꼽습니다.
| 방어 | 방식 | 한계 |
|---|---|---|
| 적대적 학습 | 학습 중에 적대적 예제를 만들어 정답 레이블과 함께 학습 | 깨끗한 입력에 대한 정확도가 떨어지고 학습 비용이 큼 |
| 랜덤 스무딩 | 가우시안 노이즈를 섞은 여러 입력의 예측을 모아 판단, 일정 범위 안의 변형에 대해 강건성을 증명 | 일부 입력에 대해서만 증명됨 |
| 형식 검증 | SMT 솔버나 추상 해석으로 신경망의 강건성을 검증 | 큰 모델로 확장하기 어렵고 계산 비용이 큼 |
세 방어 모두 강건성과 정확도 사이의 절충이 있고 학습 비용이 추가됩니다. 보고서는 정확도를 유지하면서 회피 공격에 버티는 모델을 만드는 일을 여전히 풀리지 않은 문제로 봅니다.
생성형 AI: 목표에 "오용"이 추가된 이유
생성형 AI의 분류는 예측 AI와 같은 틀을 쓰지만, 공격 목표가 하나 늘어납니다.
| 목표 | 식별자 | 뜻 |
|---|---|---|
| 가용성 파괴 | NISTAML.01 | 사용자가 모델이나 시스템의 결과를 제때 받지 못하게 함 |
| 무결성 침해 | NISTAML.02 | 시스템이 공격자의 목적에 맞는 결과를 내게 함 |
| 프라이버시 침해 | NISTAML.03 | 학습 데이터, 모델 정보, RAG 지식베이스 같은 제한된 정보를 빼냄 |
| 오용 조장 | NISTAML.04 | 시스템 운영자가 걸어 둔 사용 제한을 의도적으로 우회함 |
오용 조장(misuse enablement)은 해로운 결과를 내지 못하도록 걸어 둔 안전 장치, 예를 들어 시스템 프롬프트나 RLHF 기반 안전 정렬을 우회하는 공격을 가리킵니다. 막으려는 오용의 종류는 모델마다 다르지만, 우회하는 기법은 모델과 오용 종류를 가리지 않고 비슷하기 때문에 적대적 머신러닝의 한 분야로 묶을 수 있다는 설명입니다.
공격자 능력은 네 가지로 정리됩니다.
| 능력 | 내용 | 쓰이는 공격 |
|---|---|---|
| 학습 데이터 제어 | 학습 데이터 일부를 넣거나 바꿈 | 데이터 오염 |
| 질의 접근 | 서비스에 조작한 질의를 보냄 | 프롬프트 인젝션, 프롬프트 추출, 모델 추출 |
| 리소스 제어 | 모델이 실행 중에 읽어 들이는 문서, 웹페이지 등을 조작함 | 간접 프롬프트 인젝션 |
| 모델 제어 | 공개 파인튜닝 API나 공개된 가중치로 파라미터를 바꿈 | 모델 오염, 파인튜닝으로 안전 장치 제거 |
예측 AI에는 없던 리소스 제어가 생성형 AI 보안의 핵심입니다. 공격자는 서비스에 직접 접근하지 않아도, 모델이 나중에 읽게 될 자료만 조작하면 됩니다.
LLM이 인젝션에 약한 구조적인 이유
보고서는 LLM 애플리케이션의 여러 취약점이 한 가지 구조에서 비롯된다고 설명합니다. 데이터와 명령이 서로 다른 통로로 전달되지 않는다는 점입니다. 시스템 프롬프트, 사용자 입력, 검색해 온 문서가 모두 하나의 텍스트로 이어져 모델에 들어가기 때문에, 데이터 자리에 명령을 끼워 넣을 수 있습니다. 보고서는 이것을 수십 년 된 SQL 인젝션과 같은 종류의 결함이라고 표현합니다.
이 결함이 실제 공격으로 이어지는 지점으로 네 가지를 꼽습니다.
- 시스템 프롬프트: 개발자가 넣은 지시를 사용자 입력이 덮어쓰거나(프롬프트 인젝션), 시스템 프롬프트 자체를 빼낼 수 있습니다(프롬프트 추출).
- 외부 자료 수집: RAG나 챗봇이 실행 중에 문서와 웹페이지를 가져와 컨텍스트에 넣습니다. 이 자료를 조작하면 간접 프롬프트 인젝션이 됩니다.
- 출력 처리: 모델 출력을 웹페이지에 바로 넣거나 사람의 확인 없이 명령으로 실행하면, 모델을 속인 공격이 그대로 하위 시스템의 문제가 됩니다.
- 에이전트: 에이전트는 모델 출력으로 도구를 호출하고(3번), 그 결과를 다시 모델 입력에 넣습니다(2번). 신뢰할 수 없는 자료와 상호작용하면 에이전트가 공격자가 정한 행동을 하도록 탈취될 수 있습니다.
직접 프롬프팅과 간접 프롬프트 인젝션은 무엇이 다를까?
두 공격의 가장 큰 차이는 누가 공격하는가입니다.
| 구분 | 직접 프롬프팅 공격 | 간접 프롬프트 인젝션 |
|---|---|---|
| 필요한 능력 | 질의 접근 | 리소스 제어 |
| 공격하는 사람 | 모델의 직접 사용자 | 제3자 |
| 주로 노리는 것 | 운영자가 걸어 둔 안전 장치와 시스템 프롬프트 | 모델을 쓰는 사용자 (보고서는 많은 경우 사용자가 피해를 입는다고 설명) |
| 대표 목표 | 오용 조장, 프라이버시 침해 | 가용성, 무결성, 프라이버시 모두 |
간접 프롬프트 인젝션에서는 사용자가 아무 잘못도 하지 않았는데, 모델이 읽은 문서 때문에 사용자의 정보가 새거나 엉뚱한 답을 받게 됩니다. 보고서는 간접 인젝션으로 가용성을 깨는 방법도 소개합니다. 답하기 전에 시간이 오래 걸리는 작업을 시키거나, 특정 API를 쓰지 말라고 지시하는 식입니다.
직접 프롬프팅 공격 기법은 크게 두 갈래로 나눕니다. 하나는 경사나 탐색으로 공격 입력을 찾는 최적화 기반 공격이고, 다른 하나는 사람이 만드는 수동 공격입니다. 수동 공격은 다시 모델의 지시 따르기 성향과 안전 목표가 충돌하는 지점을 노리는 방식(competing objectives)과, 안전 학습이 다루지 못한 형태의 입력으로 우회하는 방식(mismatched generalization)으로 나뉩니다. 보고서는 이런 공격이 공개 가중치 모델에서 찾은 뒤 API로만 접근할 수 있는 폐쇄형 모델로 옮겨 가기도 한다고 지적합니다.
방어는 어디까지 와 있을까?
보고서는 방어를 모델의 수명주기 단계별로 정리합니다.
| 단계 | 방어 |
|---|---|
| 사전학습·사후학습 | 안전 학습, 적대적 학습 |
| 평가 | 자동화된 취약점 평가, 전문가 레드팀, 버그 바운티 |
| 배포 | 입력을 XML 태그로 감싸는 등 지시와 데이터를 구분하는 프롬프트 설계, 유해 입출력 탐지 모델, 프롬프트 유출 탐지, 입력 변형, 여러 프롬프트 결과 집계, 모니터링과 대응, 사용 제한 |
그러면서 현재 모델들이 직접 프롬프트 인젝션에 여전히 매우 취약하다는 연구 결과를 함께 인용합니다. 탐지 모델도 공격받을 수 있고, 감시하는 모델과 같은 방식으로 실패할 수 있다고 적었습니다.
그래서 보고서가 강조하는 것은 간접적인 완화책입니다. 모델이 악의적인 출력을 낼 수 있다고 가정하고 시스템을 설계하라는 것입니다. 민감한 데이터에 접근하거나 되돌리기 어려운 행동을 할 수 있는 모델이라면, 언젠가 그 데이터를 흘리거나 그 행동을 할 것이라고 보고 설계해야 한다는 뜻입니다. 간접 프롬프트 인젝션에 대해서는 권한이 서로 다른 여러 LLM을 나눠 쓰거나, 신뢰할 수 없는 자료는 잘 정의된 인터페이스로만 다루게 하는 설계를 예로 듭니다.
에이전트 보안에 대해서는 이제 막 연구가 시작된 단계라고 평가합니다. 취약점 평가 도구로는 AgentDojo(에이전트 대상 프롬프트 인젝션 평가), HarmBench·JailbreakBench(탈옥 평가), garak·PyRIT(오픈소스 취약점 탐색 도구) 등을 소개합니다.
보고서가 꼽은 세 가지 과제
신뢰할 수 있는 AI의 속성끼리 부딪친다
정확도만 최적화한 모델은 적대적 강건성과 공정성이 떨어지고, 적대적 강건성을 최적화한 모델은 정확도와 공정성이 떨어질 수 있습니다. 모든 속성을 동시에 최대로 만들 수는 없다는 뜻입니다. 보고서는 파레토 최적화를 현실적인 접근으로 제시합니다. 다른 속성을 해치지 않고 한 속성을 개선할 수 있는 지점이 있다면 그쪽으로 옮기고, 그 뒤에는 사용 사례에 맞춰 어떤 속성을 우선할지 조직이 정해야 한다는 것입니다.
완전한 강건성은 이론적으로 불가능할 수 있다
앞에서 본 것처럼 적대적 예제를 탐지하는 일은 강건한 분류만큼 어렵습니다. 학습 분포 밖의(OOD) 입력을 탐지하는 일도, 정상 입력과 분포가 겹치면 불가능하다는 이론적 결과가 있습니다. 항공이나 암호처럼 형식 검증으로 안전을 보증하는 방법도 있지만, 지금의 거대한 모델에 적용하기에는 비용이 너무 큽니다.
방어를 제대로 평가하기 어렵다
논문마다 가정과 방법이 달라 결과를 서로 비교하기 어렵고, 표준 벤치마크도 부족합니다. 보고서는 새 방어를 제안한 연구자가 스스로 그 방어를 깨 보려는 적응형 평가를 해야 한다고 말합니다. 기존 공격에만 테스트한 방어는 처음에는 강해 보여도 곧 새로운 공격에 뚫리는 경우가 많기 때문입니다.
실무 관점에서 읽기
위협 모델링의 공통 어휘로 쓴다
이 보고서의 가장 큰 쓸모는 식별자입니다. AI 기능이 들어간 시스템을 위협 모델링할 때, DFD의 각 요소에 STRIDE 대신 또는 STRIDE와 함께 NISTAML.015(간접 프롬프트 인젝션), NISTAML.035(프롬프트 추출) 같은 식별자를 붙여 두면, 팀 안에서도 외부 감사에서도 같은 말로 위협을 가리킬 수 있습니다.
새 공격 논문을 분류해 본다
새로 나온 공격 논문을 읽을 때 "공격 목표는 무엇이고 필요한 능력은 무엇인가"를 이 분류로 먼저 따져 보면, 우리 시스템과 관련이 있는지 빠르게 판단할 수 있습니다. 예를 들어 이전 글에서 다룬 ToolHijacker는 도구 설명 문서를 조작하는 공격이므로 리소스 제어 능력을 쓰는 간접 프롬프트 인젝션이고, 에이전트가 공격자가 고른 도구를 쓰게 만든다는 점에서 무결성 침해에 해당합니다. 우리 서비스가 외부에서 도구 목록을 받아 오지 않는다면 이 능력을 가진 공격자가 존재하는지부터 따져 보면 됩니다.
방어의 한계를 전제로 설계한다
보고서가 가장 여러 번 강조하는 메시지는 "현재의 방어로는 완전히 막을 수 없다"는 것입니다. 프롬프트 인젝션 탐지 모델을 붙였다고 끝내지 말고, 모델이 공격에 성공했을 때 무엇을 할 수 있는지를 줄이는 쪽, 즉 권한 분리와 사람의 확인 단계를 먼저 설계하는 것이 현실적입니다.
보고서의 범위와 한계
- 전통적인 사이버 공격은 다루지 않습니다. AI가 배포된 플랫폼을 노리는 공격은 기존 사이버보안 분류의 영역으로 보고 제외했습니다. 실제 시스템을 지키려면 이 보고서만으로는 부족하고, 기존 보안 통제와 함께 봐야 합니다.
- 모든 연구를 망라하지 않습니다. 보고서 스스로 널리 연구되고 현재 효과가 있는 공격을 중심으로 정리했다고 밝힙니다.
- 위험 허용 수준을 권고하지 않습니다. 어느 정도의 위험을 받아들일지는 사용 사례마다 다르기 때문입니다.
- 에이전트 부분은 짧습니다. 에이전트 보안은 연구 초기 단계라며 한 쪽 남짓으로 다룹니다. 매년 개정할 계획이라고 했으니, 다음 판에서 가장 크게 늘어날 부분으로 보입니다.
결론
NIST AI 100-2 E2025는 새로운 공격이나 방어를 제안하는 논문이 아닙니다. 대신 흩어져 있던 적대적 머신러닝 연구를 공격 목표와 공격자 능력이라는 두 축으로 정리하고, 각 공격에 식별자를 붙여 공통 언어를 만들었습니다.
정리하면 다음과 같습니다.
- 예측 AI 공격은 가용성, 무결성, 프라이버시 세 가지 목표와 여섯 가지 공격자 능력으로 나뉩니다.
- 생성형 AI에는 안전 장치를 우회하는 오용 조장이라는 목표와, 모델이 읽는 자료를 조작하는 리소스 제어라는 능력이 추가됩니다.
- LLM이 인젝션에 약한 근본 원인은 데이터와 명령이 같은 통로로 들어간다는 구조에 있습니다.
- 현재의 방어는 경험적이고 우회될 수 있으므로, 모델이 뚫릴 것을 전제로 권한과 확인 단계를 설계해야 합니다.
AI 기능이 들어간 시스템을 위협 모델링하거나 새로 나온 공격 논문을 읽을 때, 이 보고서의 분류를 먼저 대 보는 것만으로도 논의가 훨씬 정확해집니다.
참고 자료
이 글에서 다룬 보고서
- Apostol Vassilev, Alina Oprea, Alie Fordyce, Hyrum Anderson, Xander Davies, Maia Hamin, "Adversarial Machine Learning: A Taxonomy and Terminology of Attacks and Mitigations", NIST AI 100-2 E2025, 2025-03 DOI: 10.6028/NIST.AI.100-2e2025 · PDF · CSRC 페이지


