클라우드 환경 하나에는 여러 종류의 로그가 함께 쌓입니다. 가상 머신의 Linux·Windows 시스템 로그, Hadoop이나 OpenStack 같은 분산 시스템 로그, Apache·OpenSSH 같은 서버 로그, 네트워크 로그가 모두 형식이 다릅니다. 사용자마다 쓰는 서비스 조합도 달라서, 같은 클라우드 위에 있어도 계정마다 로그 구성이 제각각입니다.
로그로 이상을 탐지하려면 보통 환경마다 전처리를 따로 만듭니다. 로그 파서로 템플릿을 뽑고, 사람이 읽을 수 없는 숫자나 특수문자는 불용어로 지우고, 모르는 오류 코드는 다른 단어로 바꿉니다. 이 과정에 그 환경을 잘 아는 사람의 판단이 들어가고, 환경이 바뀌면 처음부터 다시 해야 합니다. 클라우드 사업자가 제공하는 보안 솔루션도 사용자마다 다른 환경을 모두 반영하기는 어렵습니다.
2024년 Journal of Cloud Computing에 실린 이번 논문에서는 이 전처리를 거의 없앤 침입 탐지 시스템 C-IDS(Cloud Intrusion Detection System)를 제안합니다. 로그를 공백으로 잘라 단어마다 번호만 붙이고, 오류 코드와 숫자까지 모든 단어를 그대로 학습합니다. 모델은 배포된 환경의 정상 로그만으로 학습해서, 새 로그가 이 환경에서 나올 만한 로그인지, 이상한 로그인지를 판단합니다. 공개 로그 데이터셋 7종으로 실험했더니 로그가 어느 환경에서 나왔는지 맞히는 정확도가 평균 98.2%, 이상 탐지 정확도가 평균 94.2%였습니다.
이번 글에서는 C-IDS의 구조와 로그를 숫자로 바꾸는 방법, 실험 결과를 정리하고, 실무에서 참고할 점과 한계를 살펴보겠습니다.
목차
- 논문 정보
- 클라우드 로그 탐지는 왜 환경마다 다시 만들어야 할까?
- C-IDS는 어떻게 동작할까?
- 로그를 숫자로 바꾸는 방법: 레이블 인코딩
- 모델: BI-LSTM Seq2Seq와 Bahdanau 어텐션
- 여러 환경에 한 번에 배포하기: Terraform 관리 서버
- 실험 설정
- 결과 1: 로그가 어느 환경에서 나왔는지 맞힐까?
- 결과 2: 정상 로그만 학습하고 이상을 찾아낼까?
- 모델은 어떤 단어를 보고 판단했을까?
- 실무 관점에서 읽기
- 논문의 전제와 한계
- 마치며
- 참고 자료
논문 정보
| 항목 | 내용 |
|---|---|
| 제목 | Domain knowledge free cloud-IDS with lightweight embedding method |
| 저자 | Yongsik Kim, Gunho Park, Huy Kang Kim (교신저자) · Korea University School of Cybersecurity |
| 게재 | Journal of Cloud Computing: Advances, Systems and Applications Vol. 13, Article 143 (Springer, 2024-09-27) |
| 심사 | 2023-11-13 접수, 2024-09-10 승인 |
| DOI | 10.1186/s13677-024-00707-8 |
| 라이선스 | CC BY 4.0 (오픈 액세스) |
| 데이터 | Loghub를 비롯한 공개 로그 데이터셋 7종 |
| 코드 | 공개 저장소는 없고, 요청하면 제공한다고 밝히고 있습니다 |
클라우드 로그 탐지는 왜 환경마다 다시 만들어야 할까?
논문에서 정리한 기존 연구의 한계는 크게 세 가지입니다.
- 특정 환경에 맞춘 탐지 모델이 많습니다. 모바일 클라우드 트래픽을 보는 오토인코더, 클라우드 서비스 성능 지표를 보는 이상 탐지, 가상 머신의 시스템 콜 순서를 보는 모델처럼 대부분 한 종류의 데이터만 다룹니다. 좋은 성능을 내도 다른 환경에 그대로 옮기기는 어렵습니다.
- SIEM은 결국 사람이 해석해야 합니다. 클라우드 사업자가 SIEM 구조로 탐지 체계를 만들어도, 탐지 결과를 판단하고 대응하는 데 보안 전문가가 필요합니다.
- 자연어 처리 기반 탐지도 한 종류의 로그로만 검증했습니다. 로그를 문장처럼 다루는 연구가 늘었지만, HTTP 요청 하나로만 실험하거나 알아보기 어려운 오류 코드를 지우고 학습하는 경우가 많았습니다.
그래서 저자들은 두 가지를 목표로 삼습니다. 하나는 사람이 환경별로 전처리 규칙을 만들지 않아도 되는 탐지 모델이고, 다른 하나는 이 모델을 여러 클라우드 환경에 자동으로 배포하는 방법입니다.
C-IDS는 어떻게 동작할까?
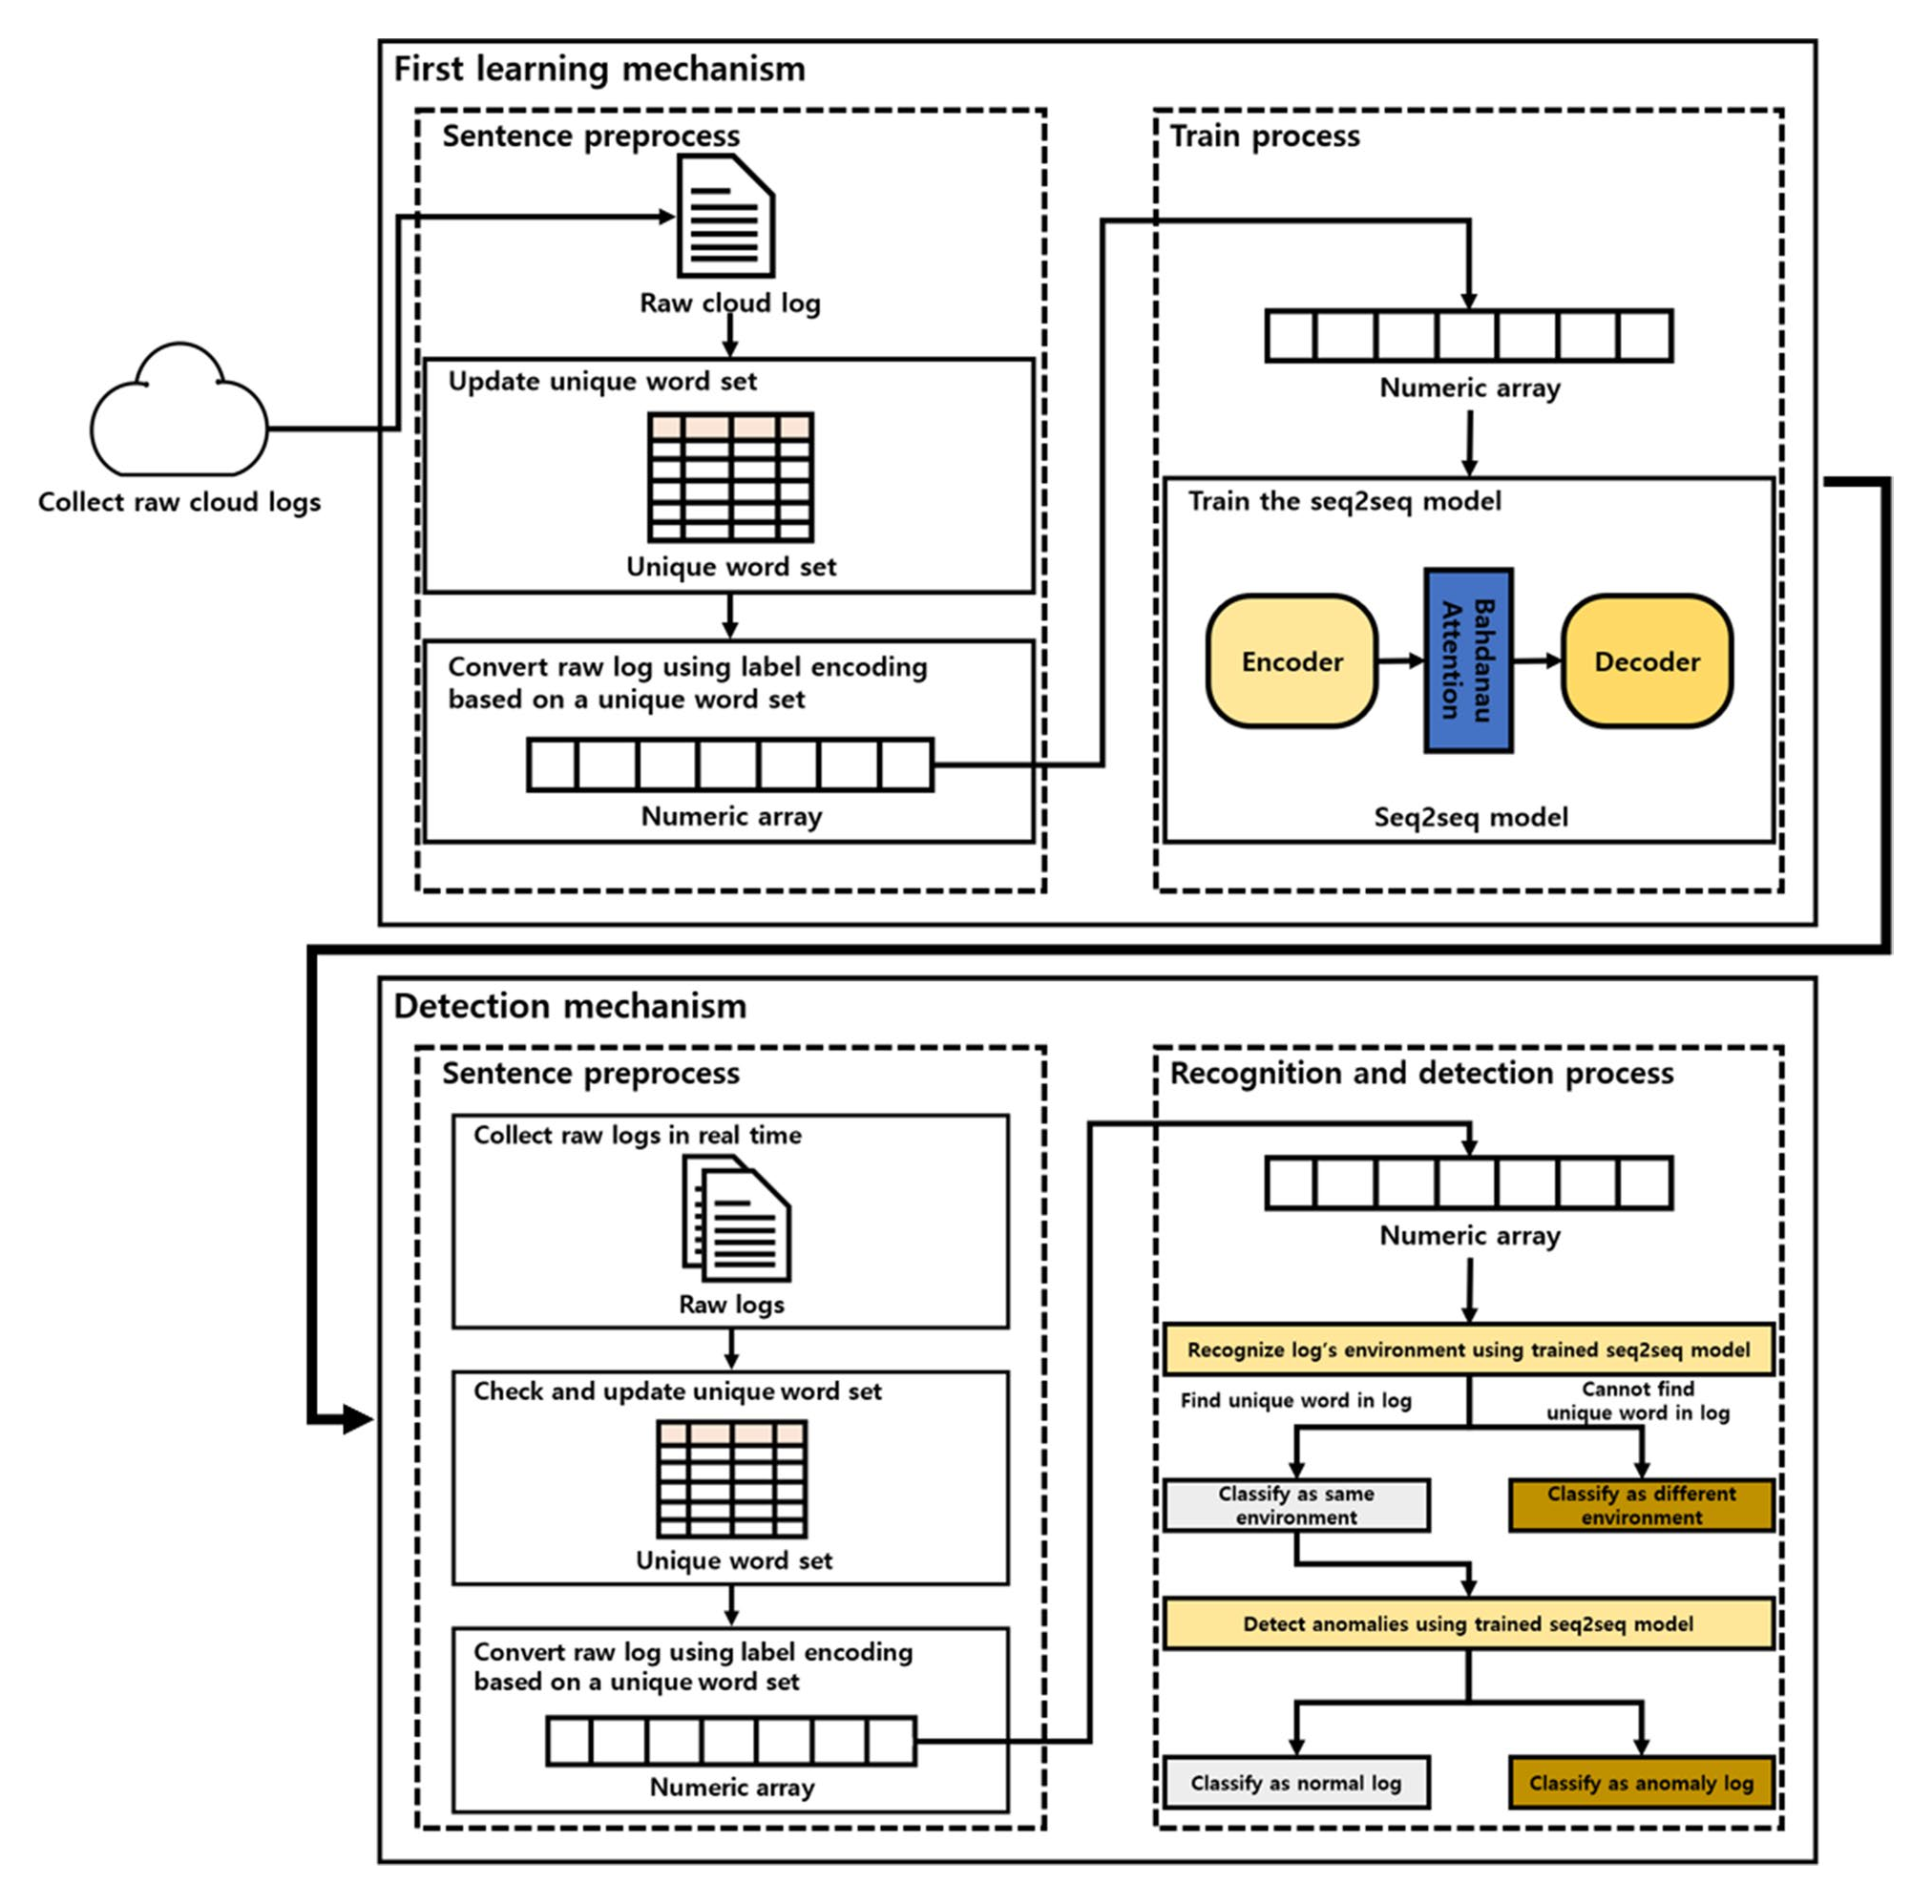
그림 출처: Kim et al., "Domain knowledge free cloud-IDS with lightweight embedding method", Journal of Cloud Computing 13:143, 2024, Fig. 1 (CC BY 4.0)
C-IDS는 두 단계로 나뉩니다. 그림 위쪽이 처음 배포될 때 한 번 도는 초기 학습(first learning mechanism)이고, 아래쪽이 이후 계속 도는 탐지(detection mechanism)입니다.
초기 학습에서는 배포된 환경에 이미 쌓여 있는 정상 로그를 모읍니다. 여기서 정상 로그는 오류 코드가 들어간 로그까지 포함해 그 환경에서 평소 나오는 로그를 말합니다. 로그를 단어로 잘라 단어 사전(unique word set)을 만들고, 각 로그를 숫자 배열로 바꿔 Seq2Seq 모델을 학습합니다.
탐지에서는 새로 들어오는 로그를 같은 방식으로 숫자 배열로 바꿉니다. 사전에 없는 단어가 나오면 사전에 추가합니다. 학습된 모델은 로그마다 그 환경의 특징을 담은 특징 단어(feature word)를 출력하고, 이 단어로 두 가지를 차례로 판단합니다.
- 환경 인식: 모델이 출력한 특징 단어가 원래 로그 안에 있으면 같은 환경의 로그로, 없으면 다른 환경의 로그로 분류합니다. 학습한 환경에서는 나올 수 없는 단어로 이뤄진 로그라는 뜻입니다.
- 이상 탐지: 같은 환경으로 분류된 로그에 대해, 특징 단어가 그 환경에서 흔히 쓰는 단어인지 봅니다. 흔하지 않은 단어면 이상 로그로 분류합니다.
두 판단 모두 정상 로그만으로 학습한 모델로 합니다. 공격 로그를 따로 모아 레이블을 붙이지 않아도 되고, 새로운 공격 기법이 나와도 모델을 고치지 않고 탐지할 수 있다는 것이 저자들의 설명입니다.
로그를 숫자로 바꾸는 방법: 레이블 인코딩
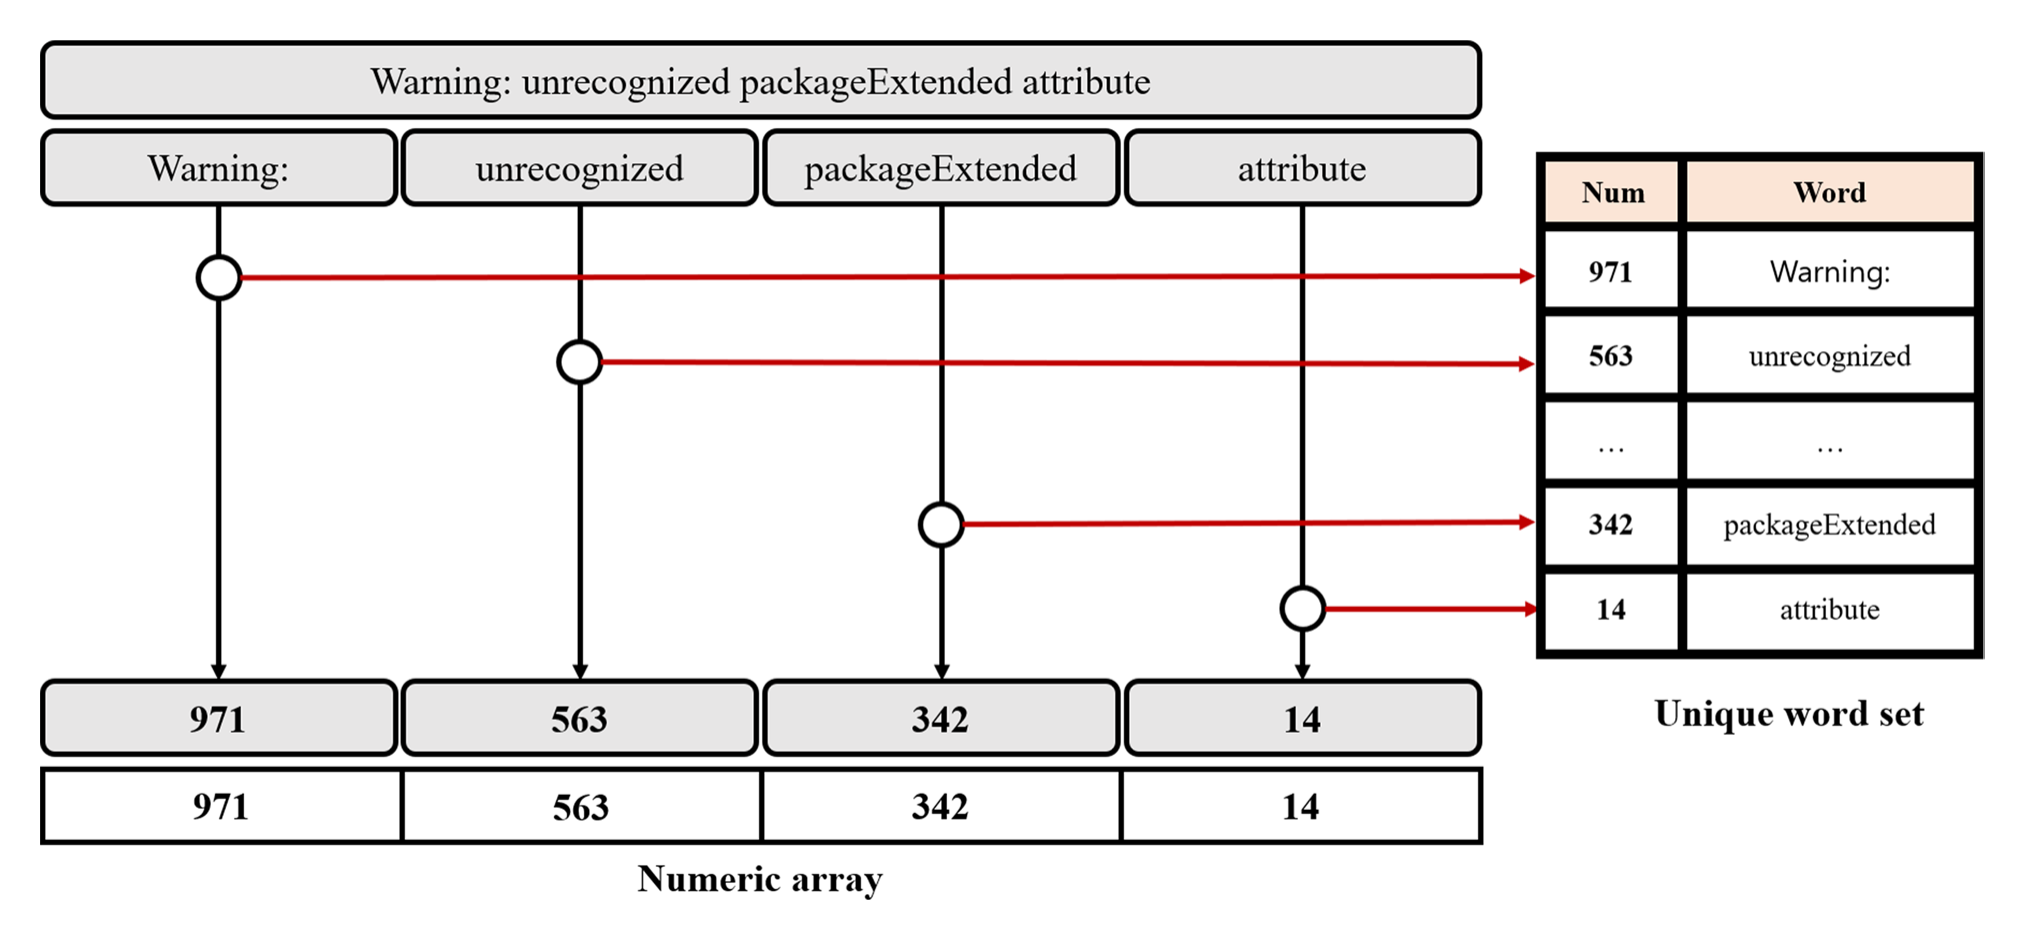
그림 출처: Kim et al., "Domain knowledge free cloud-IDS with lightweight embedding method", Journal of Cloud Computing 13:143, 2024, Fig. 2 (CC BY 4.0)
제목의 "가벼운 임베딩"(lightweight embedding)은 이 레이블 인코딩을 가리킵니다. 방법은 단순합니다.
- 로그 문장을 공백 기준으로 잘라 단어를 뽑습니다.
- 모든 환경의 로그에서 나온 단어를 모아 단어 사전을 만들고, 단어마다 고유 번호를 붙입니다.
- 로그의 각 단어를 사전 번호로 바꿔 숫자 배열을 만듭니다.
위 그림에서는 Warning: unrecognized packageExtended attribute 라는 로그가 [971, 563, 342, 14] 로 바뀝니다.
핵심은 무엇을 지우지 않는가에 있습니다. 기존 연구에서는 알 수 없는 오류 코드를 이상 값으로 취급하거나 사람이 알아볼 수 있는 단어로 바꾸는 경우가 많았습니다. 그 과정에서 정상과 이상을 가르는 단서가 되는 단어도 같이 사라졌습니다. C-IDS는 오류 코드, 16진수, IP 주소, 포트 번호까지 로그에 나온 단어를 모두 그대로 씁니다. 로그 파서도, 불용어 목록도 쓰지 않으니 환경마다 전처리 규칙을 따로 만들 필요가 없습니다. "도메인 지식이 필요 없다"(domain knowledge free)는 제목도 여기서 붙었습니다.
단어 사전은 모든 환경의 단어를 한곳에 모읍니다. 그래서 한 사용자의 여러 환경(OS, 분산 시스템, 웹 서버 등)에서 같은 사전을 함께 쓸 수 있습니다.
모델: BI-LSTM Seq2Seq와 Bahdanau 어텐션
모델은 기계 번역에 쓰는 Seq2Seq(sequence-to-sequence) 구조입니다. 인코더가 로그 문장을 읽고, 디코더가 그 로그를 대표하는 특징 단어를 출력합니다. 번역 모델이 한 언어 문장을 받아 다른 언어 문장을 내놓듯, 로그 문장을 받아 특징 단어를 내놓는 것입니다.
두 가지를 덧붙였습니다.
- 양방향 LSTM(BI-LSTM): 로그는 온전한 문장이 아니라 의미 있는 단어를 나열한 형태에 가깝습니다. 모든 단어를 고르게 반영하려고 인코더에 뒤에서 앞으로 읽는 LSTM을 더하고, 두 방향의 은닉 상태를 이어 붙였습니다.
- Bahdanau 어텐션: 로그가 길어지면 인코더가 모든 정보를 고정된 크기의 벡터 하나에 담아야 해서 정보가 빠집니다. 어텐션을 쓰면 디코더가 단어를 출력할 때마다 입력 로그의 어느 부분을 볼지 가중치를 다르게 줄 수 있습니다. 로그 길이가 제각각인 환경에 잘 맞고, 가중치를 히트맵으로 그려 모델이 어떤 단어를 보고 판단했는지 확인할 수 있습니다.
여러 환경에 한 번에 배포하기: Terraform 관리 서버
탐지 모델이 환경마다 따로 학습해야 한다면, 환경이 많을수록 배포와 관리가 부담이 됩니다. 저자들은 관리 서버(managing server)를 두고 이 과정을 자동화했습니다.
- Terraform으로 사용자 클라우드에 관리 서버를 배포합니다. Terraform은 AWS, Google Cloud, Azure를 모두 지원하므로 특정 사업자에 묶이지 않습니다.
- 관리 서버가 사용자의 클라우드 환경을 훑어 어떤 환경(OS, 분산 시스템, 서버 등)이 있는지 찾습니다.
- 찾은 환경마다 C-IDS를 배포합니다. 각 C-IDS는 그 환경의 정상 로그로 학습한 뒤 탐지를 시작합니다.
- 각 C-IDS는 상태 정보를 관리 서버로 실시간으로 보내고, 관리 서버는 학습과 탐지가 제대로 돌도록 제어합니다.
이렇게 하면 사용자가 클라우드 보안 지식 없이도 자기 환경에 맞는 탐지 체계를 갖출 수 있다는 것이 저자들의 설명입니다. 논문에는 이 과정을 의사 코드로 정리해 두었습니다.
실험 설정
Loghub를 비롯한 공개 로그 데이터셋 7종을 네 가지 시스템으로 묶어 썼습니다.
| 시스템 | 데이터셋 | 로그 수 | 이상 로그 | 크기 | 레이블 |
|---|---|---|---|---|---|
| 운영체제 | Linux | 25,567 | - | 2.25MB | 없음 |
| 운영체제 | Windows | 114,608,388 | - | 26.09GB | 없음 |
| 분산 시스템 | Hadoop | 11,175,629 | 16,838 | 1.47GB | 있음 |
| 분산 시스템 | OpenStack | 207,820 | 18,434 | 58.61MB | 있음 |
| 서버 | Apache | 56,481 | 16,803 (오류 로그) | 4.90MB | 있음 |
| 서버 | OpenSSH | 655,146 | - | 70.02MB | 없음 |
| 네트워크 | CICIDS2018 | 63,175 | 12,635 | 6.43MB | 있음 |
Apache 데이터셋은 원래 레이블이 없어서 저자들이 오류 로그 16,803건에 직접 레이블을 붙였습니다. CICIDS2018은 AWS 환경에서 DDoS, DoS, 봇, 무차별 대입, 내부 침투, 웹 공격을 재현하며 모은 데이터로, 여기서는 dhclient 등이 남긴 시스템 로그를 썼습니다.
실험은 두 가지입니다.
- 환경 인식: 특정 환경에 배포된 모델이 여러 환경의 로그가 섞인 데이터에서 자기 환경 로그만 골라내는지 봅니다. 예를 들어 Windows 환경 모델을 시험할 때는 7종 데이터셋에서 같은 개수씩 무작위로 뽑아 섞은 데이터를 씁니다. 학습과 시험 비율은 80:20입니다.
- 이상 탐지: 레이블이 있는 4종(Hadoop, OpenStack, Apache, CICIDS2018)으로, 정상 로그만 학습한 모델이 이상 로그를 골라내는지 봅니다. 이상 로그가 정상 로그보다 훨씬 적어서 SMOTE로 이상 로그를 늘려 균형을 맞췄습니다.
평가 지표는 정확도, 정밀도, 재현율, F1입니다. 특징 단어는 로그마다 두 개씩 출력했고, 이 개수일 때 결과가 가장 좋았다고 합니다.
결과 1: 로그가 어느 환경에서 나왔는지 맞힐까?
| 시스템 | 데이터셋 | 정확도 | 정밀도 | 재현율 | F1 |
|---|---|---|---|---|---|
| 운영체제 | Linux | 0.987 | 1.000 | 0.935 | 0.966 |
| 운영체제 | Windows | 0.998 | 0.995 | 0.996 | 0.995 |
| 분산 시스템 | Hadoop | 0.917 | 0.883 | 0.999 | 0.938 |
| 분산 시스템 | OpenStack | 0.982 | 0.993 | 0.988 | 0.988 |
| 서버 | Apache | 0.999 | 1.000 | 0.998 | 0.999 |
| 서버 | OpenSSH | 0.999 | 1.000 | 0.996 | 0.998 |
| 네트워크 | CICIDS2018 | 0.996 | 0.995 | 0.995 | 0.995 |
7종 평균 정확도는 98.2%입니다. 가장 낮은 Hadoop도 91.7%였고, 정밀도가 0.883으로 다른 환경의 로그를 Hadoop 로그로 잘못 본 경우가 상대적으로 많았습니다.
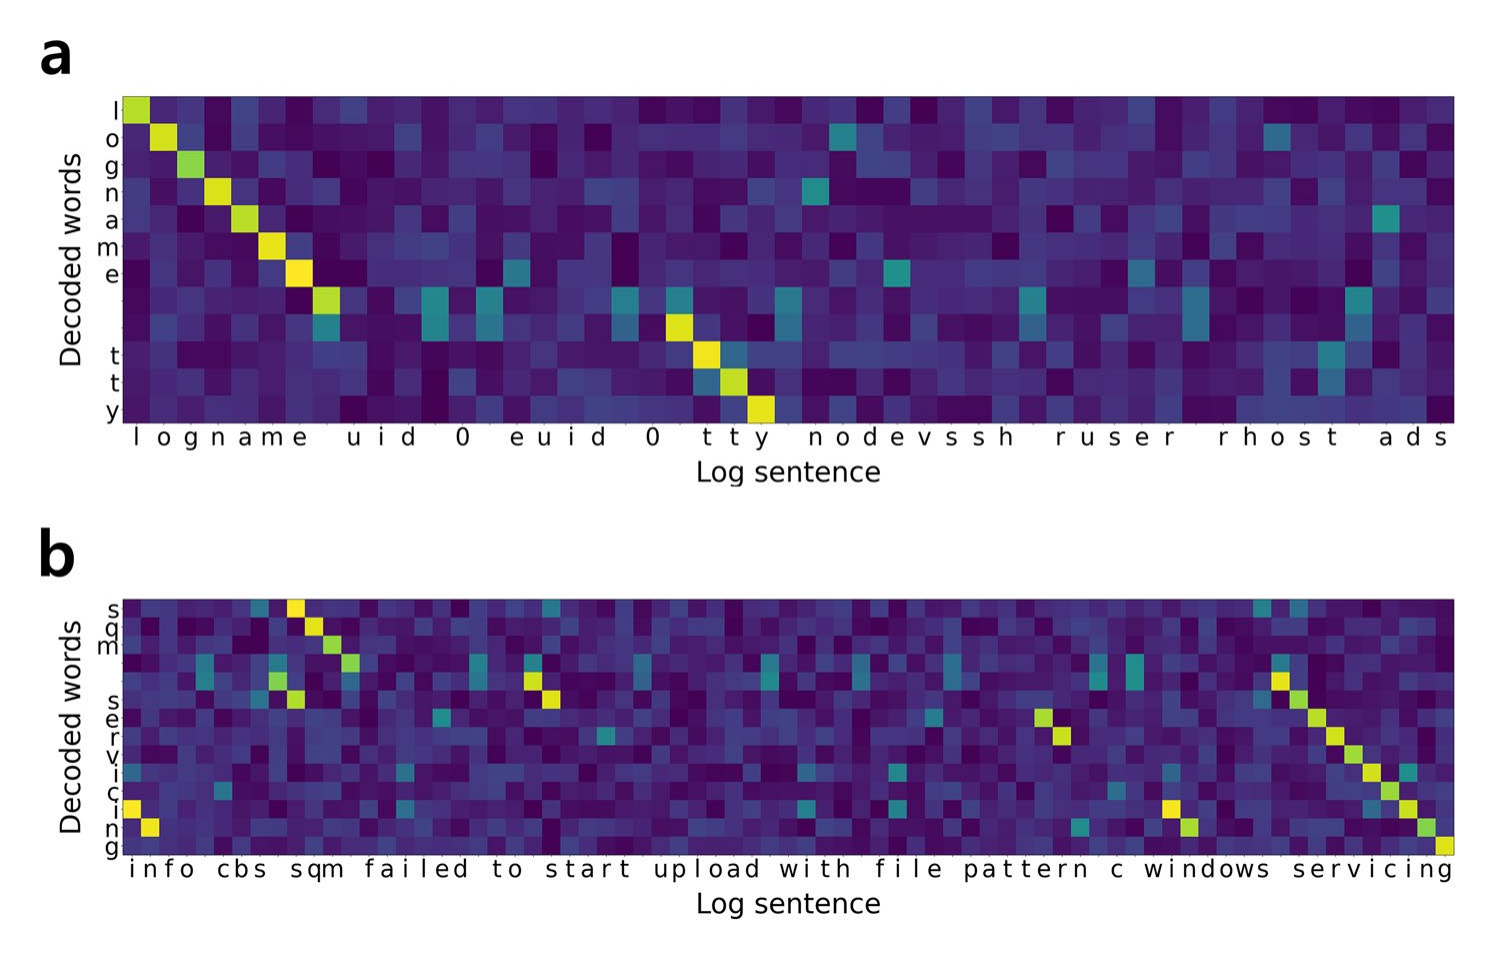
그림 출처: Kim et al., "Domain knowledge free cloud-IDS with lightweight embedding method", Journal of Cloud Computing 13:143, 2024, Fig. 7 (CC BY 4.0)
위 히트맵은 운영체제 로그에서 모델이 출력한 특징 단어(세로축)와 원래 로그 문장(가로축) 사이의 어텐션 가중치입니다. 밝을수록 가중치가 큽니다. (a) Linux 로그에서는 logname, tty 를, (b) Windows 로그에서는 sqm, servicing 을 특징 단어로 뽑았고, 대각선으로 밝게 이어진 칸이 원래 로그의 해당 위치와 정확히 맞닿아 있습니다. 모델이 각 운영체제에서만 나오는 단어를 보고 환경을 구분한 것을 확인할 수 있습니다.
결과 2: 정상 로그만 학습하고 이상을 찾아낼까?
| 시스템 | 데이터셋 | 정확도 | 정밀도 | 재현율 | F1 |
|---|---|---|---|---|---|
| 분산 시스템 | Hadoop | 0.996 | 0.949 | 0.996 | 0.971 |
| 분산 시스템 | OpenStack | 0.801 | 0.872 | 0.994 | 0.929 |
| 서버 | Apache | 0.995 | 0.999 | 0.998 | 0.999 |
| 네트워크 | CICIDS2018 | 0.976 | 0.999 | 0.909 | 0.952 |
4종 평균 정확도는 94.2%입니다. Hadoop, Apache, CICIDS2018은 97.6~99.6%로 높았고, OpenStack만 80.1%로 낮았습니다. OpenStack 로그는 요청마다 붙는 고유 ID가 많은데, 문맥만으로는 이 ID가 정상인지 판단할 수 없었기 때문입니다. 저자들은 문장 구조가 유지되는 로그에는 효과적이고, 구조가 무너진 로그에는 부분적으로만 효과가 있다고 정리합니다.
모델은 어떤 단어를 보고 판단했을까?
저자들은 모델이 맞힌 예와 틀린 예를 모아 어떤 단어가 판단을 좌우했는지 살펴봤습니다.
사람이 읽기 어려운 단어가 중요했습니다. 모델은 환경마다 특징적인 단어를 골랐는데, 그중 상당수가 숫자와 특수문자였습니다.
| 환경 | 모델이 고른 특징 단어 |
|---|---|
| Linux | logname, tty, rhost |
| Windows | windowsupdateagent, cbs, sqm |
| OpenStack | 9bc36dd9, d860ef5b8338 같은 16진수 요청 ID |
| Apache | init, child, 클라이언트 IP 주소 |
| CICIDS2018 | dhclient, dhcpack, kernel |
이상 탐지에서도 마찬가지였습니다. Apache에서는 특정 IP 주소로, OpenStack에서는 16진수 값으로 이상을 잡아냈습니다. 반대로 사람이 읽을 수 있는 단어만으로 판단한 경우에는 정상과 이상을 제대로 구분하지 못했습니다.
기존 연구 중에는 숫자와 특수문자를 불용어로 지워서 결과가 좋아진 경우도 있습니다. 하지만 실제 환경의 로그로 실험해 보니 이 값들이 인식과 탐지 정확도에 크게 영향을 줬습니다. 전처리에서 무엇을 지울지는 탐지 성능과 직결되는 결정이라는 것을 보여 주는 결과입니다.
틀린 경우는 대부분 디코딩 실수였습니다. 모델이 원래 단어 대신 비슷한 단어를 출력한 경우입니다.
- Apache 로그에
323 children이 있었는데, 모델은 학습 데이터에 자주 나온32391을 출력했습니다. - OpenStack 로그에
ae3c가 있었는데, 모델은 로그에 있던 단어 조각을 이어 붙인ae3c556f73e를 출력했습니다.
가중치가 큰 단어일수록 특징 단어로 나오기 쉬웠고, 모델이 단어를 합쳐 더 긴 단어를 만들어 내는 경우도 있었습니다. 이렇게 출력된 단어는 원래 로그에 없으므로 정상 로그가 다른 환경이나 이상으로 분류됩니다.
실무 관점에서 읽기
로그 전처리에서 숫자와 ID를 쉽게 버리지 말 것
탐지 규칙이나 모델을 만들 때 로그를 정규화하면서 요청 ID, 16진수 주소, 포트 번호를 "노이즈"로 지우는 경우가 많습니다. 이 논문의 결과를 보면 환경을 구분하고 이상을 찾는 단서가 오히려 이런 값에 있었습니다. 전처리 단계에서 필드를 버리기 전에, 그 값이 탐지에 쓰일 여지가 없는지 먼저 확인할 필요가 있습니다.
레이블 없는 환경에서 출발점으로 쓸 수 있다
새로 구축한 환경에는 공격 로그가 없어 지도 학습 모델을 만들기 어렵습니다. C-IDS처럼 정상 로그만으로 "이 환경에서 평소 나오는 로그"를 학습해 두면, 공격 데이터를 모으기 전에도 평소와 다른 로그를 걸러낼 수 있습니다. 다만 학습에 쓴 로그가 정말 정상이어야 합니다. 이미 공격이 섞인 로그로 학습하면 그 공격도 정상으로 배웁니다.
로그 출처를 확인하는 용도로도 쓸 수 있다
여러 출처의 로그를 한 파이프라인으로 모으다 보면 수집 설정이 잘못돼 엉뚱한 로그가 섞이기도 합니다. 환경 인식 단계는 "이 로그가 이 환경에서 나올 만한 로그인가"를 판단하므로, 로그 출처가 맞는지 확인하는 점검 장치로도 쓸 수 있습니다.
히트맵은 분석가에게 근거를 준다
어텐션 가중치를 히트맵으로 그리면 모델이 로그의 어느 부분에 주목했는지 볼 수 있습니다. 탐지 결과를 받은 분석가에게 로그의 어느 부분부터 보면 되는지 알려 주는 셈입니다. 다만 아래 한계에서 보듯, 어떤 단어가 판단에 얼마나 영향을 줬는지까지 수치로 설명하지는 못합니다.
논문의 전제와 한계
저자들이 직접 밝힌 한계는 세 가지입니다.
- 운영체제 로그는 레이블이 없습니다. Linux, Windows 데이터셋에는 이상 로그 표시가 없어서, 이 환경에서 이상 탐지가 정확한지는 확인하지 못했습니다. OpenSSH도 마찬가지로 이상 탐지 실험에서 빠졌습니다.
- 배포 환경에 정상 로그만 있어야 합니다. 학습 데이터에 이상 로그가 섞이면 전제가 깨집니다.
- 히트맵으로는 어떤 특징이 결과에 영향을 줬는지까지는 알 수 없습니다. 저자들은 단어 하나하나가 판단에 주는 영향을 밝히는 것을 후속 과제로 꼽았습니다.
논문을 읽으며 함께 짚어 볼 만한 부분도 있습니다.
- 다른 탐지 모델과 같은 조건에서 비교한 실험이 없습니다. 관련 연구의 성능은 정리돼 있지만, 같은 데이터셋에서 기존 로그 이상 탐지 모델과 나란히 돌린 결과는 없습니다.
- 실시간성과 경량성은 수치로 측정하지 않았습니다. 로그 한 건을 처리하는 시간이나 CPU·메모리 사용량은 나와 있지 않습니다. Terraform 관리 서버도 구조와 절차만 제시하고 따로 실험하지 않았습니다.
- 합성 이상 로그의 영향이 자세히 나와 있지 않습니다. SMOTE로 늘린 이상 로그가 학습과 시험 데이터에 각각 얼마나 들어갔는지 설명이 부족합니다.
- 단어 사전이 계속 늘어납니다. 탐지 중 처음 보는 단어는 사전에 추가되는데, 요청 ID나 16진수 값은 로그마다 새로 생깁니다. 사전이 커질 때 모델을 다시 학습하는지, 처음 보는 번호를 모델이 어떻게 처리하는지는 설명이 없습니다.
- 공개 데이터셋으로만 평가했습니다. Loghub와 CICIDS2018은 널리 쓰이는 벤치마크지만, 한 사용자의 클라우드에 여러 환경이 함께 돌아가는 실제 배포 상황과는 차이가 있습니다.
마치며
C-IDS는 클라우드의 여러 환경에서 나오는 로그를 환경별 전처리 없이 학습해 침입을 탐지하는 시스템입니다. 로그를 공백으로 잘라 단어마다 번호만 붙이고, 오류 코드와 숫자까지 모두 남긴 채 BI-LSTM Seq2Seq 모델에 학습시킵니다. 모델은 로그마다 그 환경을 대표하는 특징 단어를 출력하고, 이 단어로 로그가 어느 환경에서 나왔는지와 이상한 로그인지를 판단합니다. Terraform 관리 서버가 환경을 찾아 모델을 자동으로 배포합니다.
공개 데이터셋 7종에서 환경 인식 정확도는 평균 98.2%, 이상 탐지 정확도는 평균 94.2%였습니다. 특히 모델이 판단에 쓴 단어 상당수가 사람이 읽기 어려운 숫자, 16진수, IP 주소였다는 점은 로그 전처리에서 무엇을 지울지 다시 생각해 보게 합니다.
다른 모델과의 직접 비교, 처리 속도와 자원 사용량 측정, 레이블 없는 환경에서의 검증은 남은 과제입니다. 실무에서는 레이블이 없는 새 환경에서 평소와 다른 로그를 걸러내는 첫 단계로, 그리고 로그 전처리 설계를 돌아보는 참고 자료로 읽을 만한 논문입니다.
참고 자료
이 글에서 다룬 논문
- Yongsik Kim, Gunho Park, Huy Kang Kim, "Domain knowledge free cloud-IDS with lightweight embedding method", Journal of Cloud Computing 13, Article 143, 2024 DOI: 10.1186/s13677-024-00707-8 · Springer 논문 페이지
데이터셋
- Loghub: Linux, Windows, Hadoop, OpenStack, Apache, OpenSSH 등 시스템 로그를 모은 공개 데이터셋. He et al., arXiv:2008.06448 · GitHub
- CICIDS2018: AWS 환경에서 여러 공격을 재현하며 수집한 침입 탐지 데이터셋. Sharafaldin et al., ICISSP 2018, 데이터셋 페이지
연관 논문
- Seq2Seq: 인코더와 디코더로 문장을 다른 문장으로 바꾸는 신경망 구조. Sutskever et al., NeurIPS 2014, arXiv:1409.3215
- Bahdanau 어텐션: 디코더가 입력의 어느 부분을 볼지 학습하는 어텐션 기법. Bahdanau et al., ICLR 2015, arXiv:1409.0473
- 로그 파싱 평가: 대규모 로그에서 템플릿을 뽑는 파서 4종을 비교한 연구. He et al., "An Evaluation Study on Log Parsing and Its Use in Log Mining", IEEE/IFIP DSN 2016
- LogEvent2vec: Word2Vec을 개선해 로그 이벤트 단위로 특징을 뽑는 이상 탐지 기법. Wang et al., Sensors 20(9), 2020, DOI: 10.3390/s20092451


