AWS에서 새 애플리케이션을 만들 때 IAM 정책은 대개 넓게 시작합니다. 어떤 권한이 필요한지 아직 모르니 s3:Get*, kms:* 처럼 와일드카드를 쓰거나, AWS가 제공하는 관리형 정책을 그대로 붙입니다. 개발 속도를 생각하면 자연스러운 선택입니다.
문제는 서비스를 운영하기 시작한 뒤입니다. 최소 권한 원칙(principle of least privilege)에 맞추려면 쓰지 않는 권한을 걷어내야 하는데, 어떤 권한을 지워도 되는지 판단하기가 어렵습니다. 하나를 잘못 지우면 서비스가 멈추니 결국 넓은 정책이 그대로 남습니다.
AWS에도 이 문제를 돕는 기능이 있습니다. IAM Access Analyzer의 정책 생성 기능은 최대 90일치 CloudTrail 로그를 읽고, 실제로 쓴 서비스와 액션으로 정책 템플릿을 새로 만들어 줍니다. 다만 리소스 ARN은 자리표시자로 남아 사람이 채워야 하고, 원래 정책의 구조나 조건은 반영되지 않습니다.
OOPSLA 2024에 실린 이번 논문에서는 다른 방법을 제안합니다. 사용자가 이미 쓴 정책을 입력으로 받아서 문장 구조는 그대로 두고 값만 좁힙니다. s3:Get* 은 s3:GetObject 로, plclass/* 는 plclass/fall/* 로, 10.0.0.0/0 은 10.226.0.0/16 으로 바뀌는 식입니다. 저자들이 만든 도구 IAM-PolicyRefiner를 실제 AWS 역할 11개에 적용했더니 허용 액션이 평균 76.46% 줄었고, 역할 하나를 처리하는 데 96 vCPU 기준으로 최대 5.46초가 걸렸습니다.
이번 글에서는 이 도구가 과적합 없이 정책을 좁히는 원리와 실험 결과를 정리하고, 실무에서 쓸 때 조심할 부분을 살펴보겠습니다.
목차
- 논문 정보
- IAM 정책은 왜 처음부터 넓게 쓰일까?
- 예시 상황: 조교가 쓰는 IAM 정책은 어떻게 바뀔까?
- 좁히면서도 과적합하지 않으려면?
- 요청 하나에서 정책까지: 최소 일반화
- 필드마다 값을 어떻게 일반화할까?
- 답이 하나로 정해지지 않는 경우
- 쓰지 않는 권한 목록으로 거꾸로 좁히기
- 실험 설정
- 결과 1: 권한이 얼마나 줄었을까?
- 결과 2: 로그에 없던 요청도 허용할까?
- 결과 3: 얼마나 빠를까?
- 실무 관점에서 읽기
- 논문의 전제와 한계
- 마치며
- 참고 자료
논문 정보
| 항목 | 내용 |
|---|---|
| 제목 | Automatically Reducing Privilege for Access Control Policies |
| 저자 | Loris D'Antoni (AWS), Shuo Ding (Georgia Tech, AWS 재직 중 연구), Amit Goel, Mathangi Ramesh, Neha Rungta, Chungha Sung (AWS) |
| 게재 | Proceedings of the ACM on Programming Languages Vol. 8, OOPSLA2, Article 298, pp. 763~790 (2024-10) |
| 발표 | OOPSLA 2024 (SPLASH 2024), 2024-10-23 "Ownership, Security, and Privacy" 세션 |
| DOI | 10.1145/3689738 |
| 라이선스 | CC BY 4.0 (오픈 액세스) |
| 구현 | Scala 약 3천 줄. 논문에 코드나 아티팩트 공개 언급은 없습니다 |
저자 가운데 Neha Rungta는 AWS IAM 정책을 SMT로 분석하는 Zelkova(FMCAD 2018)와 AWS의 권한 정책 언어 Cedar(OOPSLA 2024) 논문에 모두 참여했습니다. Loris D'Antoni는 예제로 정규표현식을 고치는 RFixer(OOPSLA 2019) 같은 프로그램 합성 연구로 알려져 있습니다. 이 논문도 정책 분석보다는 프로그램 합성 쪽에 가깝습니다. 정책을 프로그램으로, 로그를 예제로 보고 예제에 맞는 프로그램을 만들어 냅니다.
IAM 정책은 왜 처음부터 넓게 쓰일까?
저자들의 설명을 정리하면 넓은 정책이 생기는 이유는 세 가지입니다.
- 개발 초기에는 빨리 움직이는 게 먼저입니다. IAM 문법이 익숙하지 않은 개발자는 Stack Overflow에서 정책을 찾아 쓰거나 AWS 관리형 정책을 붙입니다.
- 애플리케이션이 성숙해도 필요한 권한을 정확히 모릅니다. 애플리케이션에 정확히 어떤 권한이 필요한지 모르거나, 정책 언어의 의미를 헷갈리기도 합니다.
- 줄이는 작업에 시간이 많이 듭니다. 두 정책 중 어느 쪽이 더 넓은지 검증해 주는 도구(Zelkova 등)는 있지만, 새 정책을 쓰는 일은 여전히 사람 몫입니다.
그래서 저자들은 "애플리케이션이 실제로 쓴 것보다 많은 권한을 허용할 이유가 없다"는 가정에서 출발합니다. 일정 기간 CloudTrail에 쌓인 요청을 보면 필요한 권한을 알 수 있고, 거기에 맞춰 정책을 자동으로 좁힐 수 있다는 생각입니다.
예시 상황: 조교가 쓰는 IAM 정책은 어떻게 바뀔까?
논문에서는 수업에 AWS를 쓰는 강사를 예로 듭니다. 조교들은 S3 버킷에서 학생 제출물을 내려받아 채점하고, 채점한 파일을 다시 올립니다. 파일은 서버 측에서 암호화하므로 KMS 권한도 필요합니다. 강사는 조교들이 쓸 IAM 역할을 TA 라는 이름으로 만들고, 학기 전에 모의 수업을 돌려 보려고 정책을 넉넉하게 붙였습니다.

그림 출처: D'Antoni et al., "Automatically Reducing Privilege for Access Control Policies", OOPSLA 2024, Fig. 1 (CC BY 4.0)
그림 왼쪽 (a)는 모의 수업 동안 CloudTrail에 쌓인 요청, 가운데 (b)는 강사가 처음 쓴 정책 T, 오른쪽 (c)는 IAM-PolicyRefiner가 만든 정책 Tr입니다. 점선은 어떤 요청이 어떤 문장에 매칭되는지 구분하고, (b)의 빨간 부분이 (c)에서 초록 부분으로 바뀌었습니다. 리소스 이름은 논문에서 ARN을 줄여 적은 것입니다.
문장별로 바뀐 내용을 정리하면 이렇습니다.
- s1 (목록 조회):
s3prefix가*에서fall/*로 좁혀졌습니다. 요청 r1, r2의 경로가 모두fall/로 시작하기 때문입니다. - s2 (읽기):
s3:Get*이s3:GetObject로,plclass/*가plclass/fall/*로 바뀌었습니다. - s3 (쓰기):
s3:Put*이s3:PutObject로, 리소스가 채점 결과 폴더인plclass/fall/grade/*로 좁혀졌습니다. - s4 (암호화):
kms:*가kms:Encrypt,kms:Decrypt두 개로, 키가instance645:key/5df8하나로, IP 범위가10.0.0.0/0에서10.226.0.0/16으로 좁혀졌습니다.
좁혀진 정책은 로그에 나온 요청을 모두 허용합니다. 그러면서도 문장 네 개와 각 문장이 검사하는 필드는 원래 정책과 똑같고, 바뀐 곳은 값뿐입니다. 사용자는 빨간색과 초록색으로 표시된 차이만 확인하면 됩니다.
그렇다고 로그에 나온 요청만 허용하는 것은 아닙니다. 예를 들어 plclass/fall/sub/t1/ 아래 파일은 로그에 없었지만 plclass/fall/* 에 포함됩니다. 이 여유는 일부러 남겨 둔 것인데, 이유는 바로 이어서 살펴보겠습니다.
좁히면서도 과적합하지 않으려면?
로그에 맞춰 정책을 좁힐 때 쉽게 떠올릴 수 있는 답은 두 가지입니다.
- 원래 정책 P 그대로 두기: 로그의 요청을 모두 허용하지만 하나도 좁히지 않았습니다.
- 로그에 나온 요청만 나열한 정책 PR: 가장 좁지만 과적합입니다. 학생이 다른 이름으로 파일을 제출하면 바로 막힙니다. 요청을 정확히 구분하려면 원래 정책에 없던 타임스탬프나 목적지 IP까지 검사해야 해서 읽기도 어렵습니다.
저자들은 이 사이에서 답을 고르려고 세 가지 조건을 정했습니다.
| 조건 | 뜻 |
|---|---|
| 가독성(Readability) | 새 정책이 원래 정책과 문법적으로 비슷해서 차이를 사용자에게 설명할 수 있다 |
| 건전성(Soundness) | 로그의 요청을 모두 허용하고, 원래 정책보다 많이 허용하지 않는다 |
| 최소성(Tightness) | 가독성과 건전성을 만족하는 정책 가운데 가장 적게 허용한다 |
저자들은 가독성을 탐색 공간을 제한하는 방식으로 정의합니다. 후보 정책은 원래 정책과 문장 수가 같고, 각 문장이 검사하는 변수(action, resource, 조건 키)도 같아야 합니다. 바꿀 수 있는 것은 각 변수의 술어(predicate)뿐이고, 그것도 원래 술어보다 좁으면서 모양이 비슷한 술어로만 바꿀 수 있습니다. deny 문장은 건드리지 않고 allow 문장만 좁힙니다.
이렇게 후보를 제한하면 PR 같은 답은 처음부터 후보에 들어오지 않습니다. 논문에서는 이것을 머신러닝의 귀납 편향(inductive bias)에 비유합니다. 어떤 모양의 정책만 허용할지 먼저 정해 두고, 그 안에서 가장 좁은 정책을 찾는 것입니다.
요청 하나에서 정책까지: 최소 일반화
가장 좁은 정책을 찾는 데는 최소 일반화(least general generalization)라는 오래된 아이디어를 씁니다. Plotkin이 1970년에 예제로부터 논리식을 학습하는 문제에서 처음 다뤘고, Mitchell의 머신러닝 교과서에는 find-S 알고리즘으로 소개되어 있습니다. 예제를 모두 설명하는 가설 가운데 가장 구체적인 가설을 찾는 방법입니다.
논문에서는 두 가지 연산을 정의합니다.
- β (베타): 요청 하나를 받아서 그 요청만 허용하는 가장 좁은 술어를 만듭니다.
s3prefix가fall/sub/h1인 요청이면fall/sub/h1이라는 문자열 하나만 허용하는 술어가 됩니다. - ⊔ (조인): 술어 두 개를 받아서 둘을 모두 포함하는 가장 좁은 술어를 만듭니다.
fall/sub/h1과fall/grade/t2를 합치면 공통 접두사를 남긴fall/*이 됩니다. 앞의 수업 예시에서 s1이 이렇게 좁혀졌습니다.
정책 전체는 이렇게 계산합니다. 요청마다 처음으로 매칭되는 allow 문장을 찾고, 문장별로 요청을 모은 뒤, 각 필드에 β를 적용하고 ⊔로 차례로 합칩니다.
refine(P, R) = reduce(⊔, map(β, R), ⊥)
⊔ 연산은 결합법칙과 교환법칙을 만족하므로 요청을 어떤 순서로 합쳐도 결과가 같습니다. 그래서 map-reduce 방식으로 병렬 처리할 수 있습니다. 실제로 저자들은 병렬로 돌린 결과와 순차로 돌린 결과가 같다는 것을 확인했습니다.
이렇게 계산하면 문제를 잘게 나눌 수 있습니다. IAM 정책에는 두 가지 단조성이 성립하기 때문입니다.
- 문장 안의 술어를 좁히면 그 문장이 매칭하는 요청도 줄어듭니다.
- allow 문장이 매칭하는 요청이 줄면 정책 전체가 허용하는 요청도 줄어듭니다.
그래서 정책 전체를 한 번에 다룰 필요가 없습니다. 술어 종류마다 β와 ⊔를 제대로 정의해 두면 문장과 정책으로 그대로 조립됩니다. 각 술어의 추상화가 조건을 만족하면(논문 표현으로 well-behaved) 가장 좁은 정책이 유일하게 하나로 정해진다는 것도 증명되어 있습니다.
필드마다 값을 어떻게 일반화할까?
저자들은 IAM 정책에 나오는 술어 종류마다 β와 ⊔를 따로 정의했습니다. 로그에서 관찰된 값에서 출발해 필요한 만큼만 일반화하므로, 결과는 원래 정책보다 좁아집니다. 원래 술어가 무엇이었는지에 따라 일반화할 수 있는 모양이 달라집니다.
| 원래 술어 | 일반화 방식 | 예시 |
|---|---|---|
v = c (같음) |
값이 관찰되면 그대로, 아니면 아무것도 허용하지 않음 | action = s3:ListBucket |
v ≠ c (다름) |
한 값만 관찰되면 v = d, 두 값 이상이면 원래 v ≠ c |
aws:username ≠ darth |
v ≤ c (크기 비교) |
관찰된 값의 최댓값 | s3:max-keys ≤ 5000 에서 800, 1200이 관찰되면 ≤ 1200 |
? (한 글자) |
같은 글자만 나오면 그 글자, 다른 글자가 나오면 ? |
b 만 나오면 b, b 와 c 가 나오면 ? |
* (문자열) |
관찰된 문자열의 가장 긴 공통 접두사 뒤에 * (기본값) |
plclass/* → plclass/fall/* |
| 조건 여러 개의 AND | 조건마다 따로 일반화 | s3:max-keys ≥ 4000 ∧ ≤ 5000 |
| 조건 여러 개의 OR | 요청이 처음 맞는 조건만 일반화 | s3:List* ∨ s3:Get* |
문자열에서는 * 자리에 들어온 값을 어떻게 일반화할지가 핵심입니다. 기본값은 가장 긴 공통 접두사이고, 공통 접미사를 쓰거나 둘을 함께 쓰는 설정도 있습니다. 접두사와 접미사를 함께 쓸 때는 조심해야 합니다. aa 와 aaa 를 보면 공통 접두사도 aa, 공통 접미사도 aa 인데, 둘을 붙인 aa*aa 는 a 가 4개 이상인 문자열만 받아서 원래 요청을 막아 버립니다. 그래서 문자열 길이가 접두사와 접미사 길이의 합 이상일 때만 둘을 합칩니다.
값 몇 개를 목록으로 들고 있다가 개수가 넘치면 접두사로 넘어가는 방식도 고를 수 있습니다. 논문에 따로 설명은 없지만, 정의대로 계산하면 수업 예시의 s4 결과 kms:Encrypt, kms:Decrypt 는 이 방식일 때 나옵니다. 기본값인 공통 접두사 방식이면 Encrypt 와 Decrypt 에 공통 접두사가 없어 kms:* 가 그대로 남습니다. IP 범위도 예시에서는 세 주소가 공유하는 앞 16비트를 남겨 10.226.0.0/16 으로 좁혀졌습니다.
좁히지 않고 그대로 두는 술어도 있습니다.
- 정책 변수:
home/${aws:username}/*처럼 요청마다 값이 바뀌는 조건은 건드리지 않습니다. - 부정 연산자:
StringNotLike같은 연산자는 단조성을 깨뜨려서 원래 술어를 그대로 둡니다. ...IfExists,ForAllValues:: 값이 없음을 뜻하는null과 OR를 조합한 형태로 바꿔서 처리합니다.
답이 하나로 정해지지 않는 경우
가장 좁은 정책이 유일하다는 보장에는 조건이 붙습니다. 조건이 깨지는 경우는 크게 셋입니다.
allow 문장끼리 겹칠 때. 리소스가 a* 인 문장과 *b 인 문장이 있고 요청의 리소스가 ab 라고 해 보겠습니다. 두 문장 모두 이 요청과 매칭합니다. 첫 번째 문장을 ab* 로 좁히고 두 번째를 비워도 되고, 반대로 두 번째를 *ab 로 좁히고 첫 번째를 비워도 됩니다. 둘 중 어느 쪽이 더 좁다고 말할 수 없습니다. 문장끼리 겹치는지는 Zelkova로 판정할 수 있습니다.
패턴이 모호할 때. a*a* 처럼 문자열 하나를 여러 방식으로 매칭할 수 있는 패턴은 첫 번째 매칭만 보고 좁히기 때문에 더 좁은 답을 놓칠 수 있습니다. 논문에서는 이런 패턴이 IAM에서 흔하지 않고 바람직하지도 않다고 봅니다.
OR 조건끼리 겹칠 때. 문장이 겹치는 경우와 같은 문제입니다.
세 경우 모두 결과 정책이 가장 좁다는 보장만 사라집니다. 로그의 요청을 모두 허용하고 원래 정책보다 넓지 않다는 건전성과 가독성은 그대로 유지됩니다.
쓰지 않는 권한 목록으로 거꾸로 좁히기
로그 대신 "이 권한은 쓰지 않는다"는 목록이 주어지는 경우도 있습니다. IAM Access Analyzer는 일정 기간 쓰이지 않은 권한을 미사용 접근 결과(unused access findings)로 알려 줍니다. 논문에서는 이 목록으로 정책을 좁히는 변형을 IAM-PolicyRefinerNeg라는 이름으로 함께 다룹니다.
이때 목표는 반대가 됩니다. 목록에 있는 요청을 모두 막으면서 가장 많이 허용하는 정책을 찾아야 합니다. 가장 좁은 정책을 찾으면 모든 요청을 막는 정책이 답이 되어 버리기 때문입니다.
allow 문장을 직접 좁히려 하면 답이 여러 개 생깁니다. * 에서 aaa 하나를 빼려면 b* 로 바꿔도 되고 c* 로 바꿔도 됩니다. 그래서 저자들은 allow 대신 deny 문장을 하나 추가합니다. 모든 것을 거부하는 (deny, action: *, resource: *) 에서 출발해서, 목록의 요청을 모두 거부하는 가장 좁은 deny 문장을 앞서 만든 β와 ⊔로 계산합니다. deny 문장이 좁을수록 정책은 많이 허용하므로 같은 알고리즘을 그대로 쓸 수 있습니다.
실험에서는 원하지 않은 결과가 나왔습니다. Access Analyzer가 미사용 액션 목록만 알려 주기 때문에 이 실험에서는 액션만 일반화했는데, 기본값인 공통 접두사 방식으로 돌렸더니 6개 역할 모두에서 (deny, action: *, resource: *) 이 그대로 나왔습니다. 모든 요청을 거부하는 정책입니다. lambda:DeleteFunction 과 logs:CreateGroup 처럼 서비스가 다른 액션이 목록에 섞이면 공통 접두사가 없기 때문입니다.
그래서 값 목록을 유지하는 방식으로 바꾸고, deny 문장이 액션을 전부 나열하지 않도록 트라이(trie)로 묶었습니다. 예를 들어 s3:List 로 시작하는 액션이 모두 미사용이면 s3:List* 한 줄로 줄입니다. 이렇게 하니 역할별 허용 액션이 평균 56.58%(18.18~97.7%) 줄었습니다. 문자열을 어떻게 일반화할지 정하는 작은 설정 하나가 결과를 완전히 바꾼 사례입니다.
실험 설정
| 항목 | 내용 |
|---|---|
| 대상 | 동료들이 제공한 AWS 계정 4개의 IAM 역할 11개 + 수업 예시(mot, 요청 10만 건을 직접 생성) |
| 정책 | 역할당 정책 1~5개, 정책당 문장 1~19개. 역할에 붙은 정책의 문장을 모두 합쳐서 처리 |
| 로그 | 같은 역할의 2023년 연속 3개월 CloudTrail 로그, 역할당 65,456~322,100건 |
| 미사용 결과 실험 | 계정 2개의 역할 6개, IAM Access Analyzer 180일 미사용 결과. 이 기능이 2023년 말에 나와 앞의 11개 역할에는 쓰지 못함 |
| 환경 | EC2 m5.24xlarge (96 vCPU). 6번 실행해 첫 번째를 빼고 평균 |
| 검증 | IAM Access Analyzer의 정책 검사로 모든 결과 정책이 원래 정책보다 넓지 않음을 확인 |
정책이 허용하는 액션 수는 Zelkova로 세었습니다. s3:Get* 이 실제로 몇 개의 액션을 허용하는지 계산한 값입니다.
결과 1: 권한이 얼마나 줄었을까?
역할별 결과는 다음과 같습니다. 리소스와 조건 열은 "바뀐 값 / 전체 값"입니다.
| 역할 | 요청 수 | 정책 | 문장 | 허용 액션 | 리소스 | 조건 |
|---|---|---|---|---|---|---|
| mot | 100,000 | 1 → 1 | 4 → 4 | 148 → 3 | 4/4 | 2/2 |
| role1 | 78,568 | 1 → 1 | 3 → 1 | 4 → 2 | 3/3 | 0/0 |
| role2 | 76,571 | 2 → 2 | 6 → 4 | 83 → 11 | 6/6 | 0/1 |
| role3 | 197,100 | 5 → 3 | 76 → 12 | 726 → 20 | 75/131 | 27/28 |
| role4 | 86,003 | 3 → 1 | 7 → 3 | 10 → 3 | 7/7 | 0/0 |
| role5 | 229,580 | 1 → 1 | 4 → 3 | 6 → 3 | 4/4 | 0/0 |
| role6 | 151,844 | 1 → 1 | 1 → 1 | 7 → 2 | 1/1 | 0/0 |
| role7 | 76,748 | 2 → 2 | 4 → 3 | 7 → 4 | 4/4 | 0/0 |
| role8 | 135,049 | 4 → 2 | 9 → 2 | 39 → 2 | 8/12 | 0/0 |
| role9 | 65,456 | 1 → 1 | 9 → 6 | 78 → 5 | 5/12 | 1/2 |
| role10 | 92,521 | 2 → 2 | 6 → 5 | 83 → 13 | 6/6 | 0/1 |
| role11 | 322,100 | 3 → 2 | 3 → 2 | 235 → 2 | 3/3 | 0/0 |
11개 역할 모두에서 액션이 하나 이상 줄고 리소스 값이 하나 이상 바뀌었습니다.
- 액션: 평균 76.46% 줄었습니다(50~99.15%). role11은 235개에서 2개가 되었습니다.
- 리소스: 평균 87.79%의 값이 좁혀지거나 사라졌습니다(41.67~100%).
- 조건: 조건이 있는 역할은 5개뿐이었고, 좁혀진 비율은 0~96.43%였습니다. 조건은 보통 사용자가 이미 구체적인 값으로 적어 두기 때문에 좁힐 여지가 적습니다. 그래도 role3은 28개 중 27개가 바뀌었습니다.
- 문장·정책 삭제: 로그의 어떤 요청과도 매칭되지 않은 문장은 통째로 사라졌습니다. role3은 정책이 5개에서 3개로, 문장이 76개에서 12개로 줄었습니다.
관리형 정책에서 효과가 컸습니다. 11개 역할에 붙은 AWS·고객 관리형 정책은 12개였는데, 이런 정책은 여러 사용 사례를 한꺼번에 지원하느라 액션을 넓게 허용합니다. role2에 붙은 관리형 정책 하나는 액션 80개를 허용하고 있었습니다.
결과 2: 로그에 없던 요청도 허용할까?
로그에 딱 맞춰 좁히면 나중에 들어오는 정상 요청이 막힐 수 있습니다. 저자들은 로그를 시간순으로 잘라 앞쪽 X%만으로 정책을 좁히고, 그 정책이 전체 요청 중 몇 %를 허용하는지 확인했습니다. 100%보다 낮으면 막히면 안 되는 요청이 막혔다는 뜻입니다.
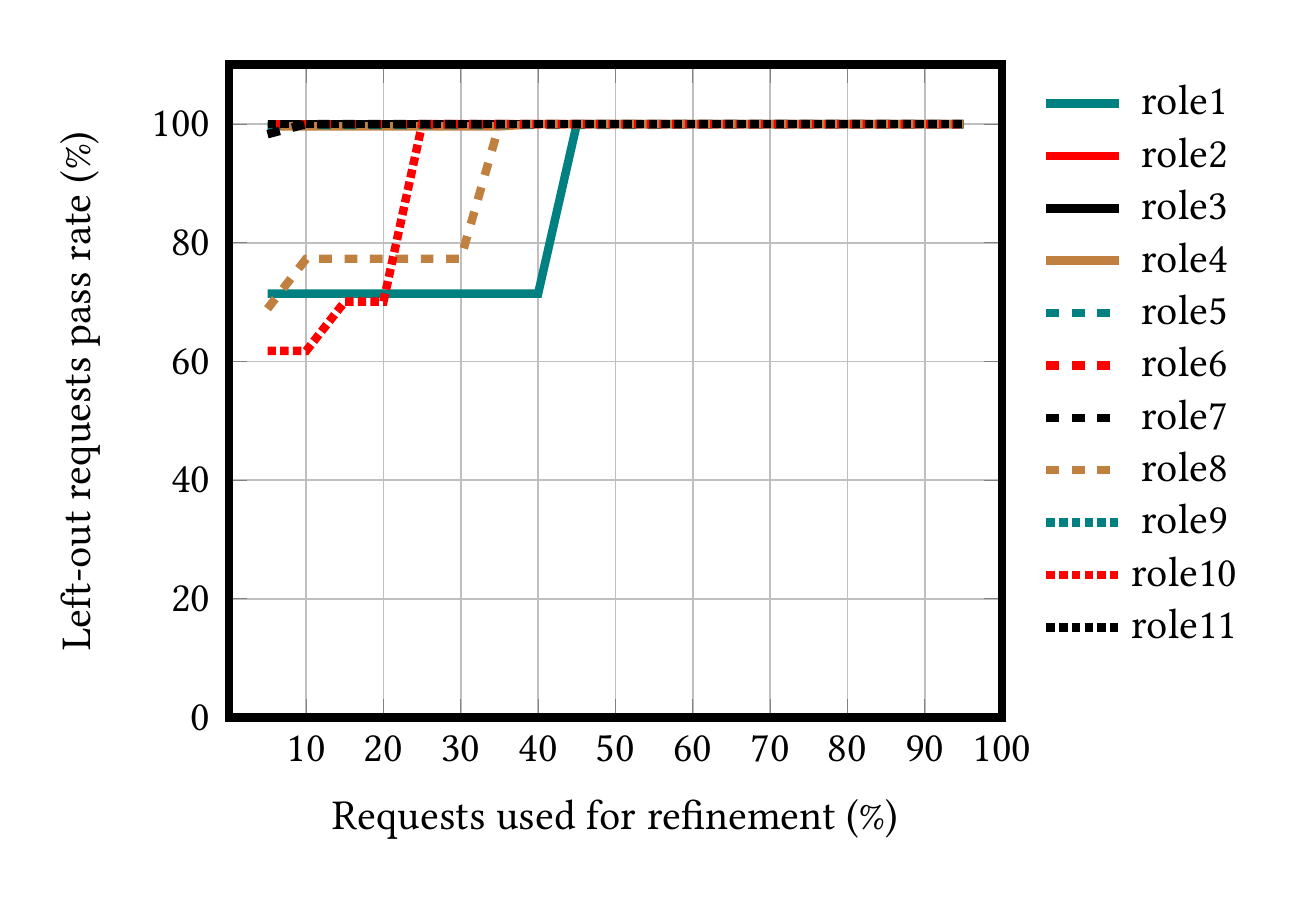
그림 출처: D'Antoni et al., "Automatically Reducing Privilege for Access Control Policies", OOPSLA 2024, Fig. 4 (CC BY 4.0)
가로축은 정책을 좁히는 데 쓴 로그 비율, 세로축은 전체 요청 가운데 허용된 비율입니다.
- 로그의 5%만 써도 11개 중 6개 역할은 전체 요청을 모두 허용했습니다.
- 로그의 50%를 쓰면 모든 역할이 전체 요청을 허용했습니다.
- 가장 나빴던 경우는 role10으로, 로그의 10%만 쓰면 전체 요청의 62%만 허용했습니다. 그래프에서 가장 오래 100%에 못 미친 역할은 role1입니다. 로그의 40%를 쓸 때까지 70%대에 머물렀습니다.
5%로 부족했던 역할들은 공통점이 있었습니다. 로그 앞부분에 리소스를 만들거나 데이터를 쓰는 요청이 몰려 있었고, 뒤에서는 그 리소스를 지우거나 데이터를 다른 곳으로 옮겼습니다. 앞부분만 보면 뒤에 나오는 리소스 이름을 알 수 없으니 공통 접두사가 너무 길게 잡힐 수 있습니다. 저자들은 두 달 이상의 로그를 쓰면 처음 보는 요청에도 잘 일반화된다고 정리합니다.
결과 3: 얼마나 빠를까?
| 1 CPU | 96 vCPU | |
|---|---|---|
| 가장 빠른 역할 | 5.36초 (role1) | 1.00초 (role1) |
| 가장 느린 역할 | 75.33초 (role3) | 5.46초 (role3) |
병렬화로 기하평균 8.7배 빨라졌습니다. 96 vCPU에 비하면 크지 않은 향상인데, 저자들은 조인 계산 자체가 가벼워서 병렬화에 드는 비용이 상대적으로 크다고 설명합니다.
요청을 문장에 짝짓는 시간은 요청 수와 문장 수에 비례하고, 조인 시간은 문장에 든 변수와 조건 수에 좌우됩니다. role3이 가장 느린 것도 문장 76개, 리소스 값 131개, 조건 28개로 가장 복잡했기 때문입니다.
실무 관점에서 읽기
Access Analyzer 정책 생성과는 쓰임새가 다르다
같은 CloudTrail 로그를 쓰지만 결과물의 모양이 다릅니다.
| IAM Access Analyzer 정책 생성 | IAM-PolicyRefiner | |
|---|---|---|
| 출발점 | CloudTrail 활동 (기존 정책과 무관하게 새로 생성) | 사용자가 쓴 기존 정책 |
| 좁히는 대상 | 서비스·액션 (지원하는 서비스만 액션 단위) | 액션, 리소스, 조건 값 |
| 리소스 | ARN 자리표시자를 사람이 채움 | 로그에서 관찰된 경로로 자동으로 좁힘 |
| 검토 방법 | 새로 만든 정책 전체를 읽어야 함 | 원래 정책과의 diff만 보면 됨 |
기존 정책에 이미 팀의 의도가 담겨 있다면 IAM-PolicyRefiner 방식이 검토하기 훨씬 수월합니다. 앞의 수업 예시에서 읽기(s2)와 쓰기(s3)를 나눠 둔 구조가 결과에도 그대로 남기 때문입니다.
로그에 남는 것만 좁힐 수 있다
앞의 수업 예시에서 plclass/fall/sub/t2/jane.pdf 같은 객체 경로를 알 수 있었던 것은 로그에 s3:GetObject 요청이 남아 있었기 때문입니다. 실제 CloudTrail에서 S3 객체 단위 요청은 데이터 이벤트로 분류되고, 기본 설정으로는 기록되지 않습니다. 데이터 이벤트를 따로 켜지 않은 계정에서는 이런 요청이 로그에 없으니, 같은 방법을 쓰면 해당 권한이 쓰이지 않은 것으로 보고 지워 버립니다. 로그를 입력으로 쓰기 전에 어떤 이벤트가 기록되고 있는지부터 확인해야 합니다.
로그 기간이 곧 권한 범위다
분기마다 한 번 도는 배치, 장애 때만 쓰는 복구 절차, 연 1회 감사 대응 작업처럼 드물게 쓰는 권한은 로그 기간에 들어 있지 않으면 사라집니다. 결과 2에서 본 것처럼 리소스를 만드는 요청과 지우는 요청이 시간차를 두고 나타나기도 합니다. 결과 정책을 바로 적용하기보다 diff를 보면서 "이 권한이 없어져도 되는가"를 사람이 확인하는 단계가 필요합니다. 저자들이 가독성을 첫 번째 조건으로 둔 것도 이 검토를 쉽게 하려는 것입니다.
이미 침해된 역할에는 쓰면 안 된다
저자들은 로그에 악의적인 요청이 없다고 가정합니다. 공격자가 이미 역할을 쓰고 있었다면, 그 요청도 "애플리케이션이 쓴 권한"으로 취급되어 좁혀진 정책에 남습니다. 섀도 모드로 먼저 돌린 뒤 배포하는 환경이라면 합리적인 가정이지만, 운영 중인 역할에 적용할 때는 로그 기간에 이상 행위가 없었는지 먼저 확인해야 합니다.
좁히지 못하는 부분은 따로 본다
정책 변수(${aws:username})와 부정 연산자(StringNotLike 등)는 원래 값이 그대로 남습니다. 문장끼리 겹치는 정책도 결과가 가장 좁다는 보장이 없습니다. 실험에서도 11개 중 2개 역할에서 한 요청을 여러 문장이 동시에 허용했습니다. 결과 정책에서 이런 부분은 사람이 직접 봐야 할 목록으로 따로 뽑아 두는 게 좋습니다.
논문의 전제와 한계
- 평가 규모가 작습니다. 저자들의 동료가 제공한 계정 4개의 역할 11개이고, 저자들도 개발 계정의 정책과 로그로 평가했다고 밝힙니다. 수백 개 역할이 얽힌 운영 계정에서 어떻게 동작할지는 알 수 없습니다.
- 다른 도구와 비교하지 않았습니다. 로그에서 정책을 뽑는 기존 연구는 대부분 머신러닝 기반이거나 등호 조건만 다루는 단순한 언어를 대상으로 해서 비교할 수 없었다고 설명합니다. 같은 회사의 Access Analyzer 정책 생성과도 비교하지 않았습니다.
- 최소성은 탐색 공간 안에서만 성립합니다. 원래 정책에 없던 조건 키를 새로 추가하는 식의 좁히기는 할 수 없습니다. TACAS 2026에 실린 Restricter 논문에도 같은 지적이 있습니다. IAM-PolicyRefiner는 원래 문장에 있는 술어만 고칠 수 있고, Restricter는 원래 없던 술어도 새로 넣을 수 있어서 좁힐 수 있는 경우가 더 많다고 합니다.
- 과적합 평가는 한쪽만 봅니다. 결과 2는 "막으면 안 되는 요청을 막았는가"만 측정합니다. 좁혀진 정책에 여전히 남은 불필요한 권한이 얼마인지는 정답이 없어 측정하지 않았습니다.
- 처리 시간 표기가 곳곳에서 다릅니다. 논문 안에서도 역할당 1분 이내라고 한 곳과 정책당 5초 이내라고 한 곳이 섞여 있습니다. 실험 결과 표 기준으로는 96 vCPU에서 최대 5.46초, 1 CPU에서 최대 75.33초입니다.
- AWS IAM만 다룹니다. Cedar, Google Cloud IAM, Azure Policy도 allow/deny 구조가 비슷해 확장할 수 있다고 하지만, Cedar의
unless처럼 단조성을 깨는 문법은 그대로 적용하기 어렵다고 스스로 밝힙니다.
마치며
IAM-PolicyRefiner는 CloudTrail 로그를 예제로 삼아, 사용자가 쓴 정책을 같은 모양 그대로 가장 좁게 줄이는 도구입니다. 문장과 필드 구조는 건드리지 않고 s3:Get* 을 s3:GetObject 로, plclass/* 를 plclass/fall/* 로 바꾸는 식이라 결과를 diff 하나로 검토할 수 있습니다. 문자열은 공통 접두사, 숫자는 최댓값처럼 필드마다 값을 일반화하는 규칙을 정해 두고, 그 규칙을 조립해 정책 전체의 답을 구합니다. 조건이 맞으면 답이 하나로 정해진다는 증명도 있습니다.
실험에서는 실제 역할 11개의 허용 액션이 평균 76% 줄었고, 두 달 이상의 로그를 쓰면 로그에 없던 정상 요청도 막지 않았습니다. 반대로 미사용 권한 목록으로 좁히는 실험에서는 문자열 일반화 규칙 하나 때문에 모든 요청을 막는 정책이 나오기도 했습니다. 자동으로 좁힌 정책도 결국 로그와 설정에 기대고 있다는 것을 보여 주는 결과입니다.
실무에 가져온다면 결과를 바로 배포하기보다 권한 축소 후보를 뽑아 주는 용도가 알맞습니다. 로그에 어떤 이벤트가 남는지, 로그 기간에 드문 작업이 들어 있는지, 그 기간에 침해 흔적은 없는지를 먼저 확인하고, diff를 사람이 검토한 뒤 적용하면 됩니다.
참고 자료
이 글에서 다룬 논문
- Loris D'Antoni, Shuo Ding, Amit Goel, Mathangi Ramesh, Neha Rungta, Chungha Sung, "Automatically Reducing Privilege for Access Control Policies", Proc. ACM Program. Lang. 8(OOPSLA2), Article 298, 2024 DOI: 10.1145/3689738 · SPLASH 2024 발표 페이지 · Amazon Science
연관 논문
- Zelkova: AWS IAM 정책을 SMT 식으로 바꿔 두 정책의 포함 관계를 판정하는 도구. 이 논문에서 문장 겹침 판정과 허용 액션 수 계산에 썼습니다. Backes et al., FMCAD 2018, DOI: 10.23919/FMCAD.2018.8602994
- Cedar: AWS가 만든 권한 정책 언어. 논문에서 확장 대상으로 꼽았습니다. Cutler et al., OOPSLA 2024, DOI: 10.1145/3649835
- Restricter: 접근 로그로 Cedar 정책의 permit 규칙을 좁히는 도구. 원래 정책에 없던 술어를 추가할 수 있습니다. Wu et al., TACAS 2026, arXiv:2601.14582
- Quantitative Policy Repair: 클라우드 접근 제어 정책을 정량적인 기준으로 고치는 기법. Eiers et al., "Quantitative Policy Repair for Access Control on the Cloud", ISSTA 2023
- Quantifying Permissiveness: 접근 제어 정책이 얼마나 넓은지 수치로 재는 방법. Eiers et al., ICSE 2022, DOI: 10.1145/3510003.3510233
- Mining ABAC Rules from Sparse Logs: 로그에서 접근 제어 규칙을 처음부터 뽑아내는 기존 방식의 대표 연구. Cotrini et al., IEEE EuroS&P 2018, DOI: 10.1109/EuroSP.2018.00011
- RFixer: 예제로 정규표현식을 고치는 도구. 와일드카드가 매칭한 부분 문자열을 찾는 방식이 이 논문과 비슷합니다. Pan et al., OOPSLA 2019, DOI: 10.1145/3360565
- Inductive Generalization: 최소 일반화를 처음 제안한 논문. Plotkin, Machine Intelligence 5, 1970
AWS 문서
- IAM Access Analyzer 정책 생성: CloudTrail 활동으로 정책 템플릿을 만드는 기능
- IAM Access Analyzer 결과 유형: 미사용 접근 결과 포함
- IAM JSON 정책 요소 레퍼런스


